Канал с гайдами и контентом по ИИшкам и что с ними можно реализовывать: https://t.me/claudedevolper
Каждый, кто хоть раз работал с ИИ-агентами, рано или поздно приходит к идее «второго мозга». Вдохновившись красивыми графами заметок пользователей Obsidian, кажется, что создать умного ассистента с бесконечной памятью — проще простого. Достаточно загрузить все свои заметки, статьи и файлы в папку агента — и вот он, персональный ИИ, который знает о тебе буквально всё.
Но реальность быстро возвращает на землю. После загрузки данных оказывается, что агент «не понимает» заметки, не может найти нужную информацию и забывает контекст уже через несколько минут.
Почему так происходит?
В этой статье мы разберёмся, как на самом деле работают ИИ-агенты и почему интеграция с личной базой знаний — это не просто «закинул файлы и готово». Поговорим о ключевых проблемах и технологиях, без которых невозможно построить полноценный «второй мозг».
Вы узнаете:
— Почему ИИ-агент не находит нужные заметки даже при наличии данных
— Как работает семантический поиск и чем он отличается от поиска по ключевым словам
— Что такое RAG (Retrieval-Augmented Generation) и зачем он нужен
— Как устроены векторные базы данных и почему без них не обойтись
— Почему перелинковка заметок в Obsidian не помогает ИИ лучше понимать контент
— Реально ли создать цифровой «второй мозг» и какие инструменты для этого использовать
Мы подробно разберём эти вопросы и пройдёмся по внутренней логике работы современных ИИ-агентов — без иллюзий и с практическим подходом.
Содержание
- Введение
- Что такое RAG
- Как построить RAG с нуля
- Продвинутые техники RAG
- Готовые решения (под ключ)
Введение
Начнём с важного и немного неприятного факта: у ИИ-агента нет памяти в привычном смысле.
Да, это звучит странно, особенно если ты рассчитывал на «второй мозг» или цифрового ассистента, который помнит всё. Но на практике любой современный ИИ-агент работает в рамках ограниченного контекстного окна.
Что в него входит:
- Данные текущей сессии — все сообщения, файлы и инструкции, которые ты передал прямо сейчас
- Ограниченные фрагменты предыдущих диалогов (если система их подтягивает)
- Системные правила (rules)
- Навыки или инструменты (skills)
- Дополнительные механизмы вроде auto-memory (например, в Claude Code)
И всё.
Через несколько минут или при переполнении контекста часть информации просто исчезает. Именно поэтому агент может забыть задачу, которую ты дал ему совсем недавно.
Тогда что такое «память агента»?
То, что мы называем памятью ИИ-агента, на самом деле — это не встроенная функция, а внешняя система хранения данных + механизм их умного извлечения.
Проще говоря:
Память агента = база знаний + поиск + подгрузка релевантной информации в контекст
И вот этот механизм как раз и называется RAG (Retrieval-Augmented Generation).
Что такое RAG и как он работает
RAG (Retrieval-Augmented Generation) — это подход, при котором ИИ не пытается «запомнить всё», а вместо этого достаёт нужную информацию из внешнего источника в момент запроса.
Это ключевая технология, если ты хочешь:
- построить «второй мозг»
- подключить заметки из Obsidian
- работать с большими объёмами данных
- сделать ИИ-ассистента, который реально полезен
Как работает RAG (простым языком):
- Ты задаёшь вопрос
Например: «Что я писал про семантический поиск?» - Система ищет релевантные данные
Не по ключевым словам, а по смыслу (через эмбеддинги и векторный поиск) - Находит подходящие фрагменты
Из твоих заметок, документов или базы знаний - Подставляет их в контекст модели
То есть «показывает» агенту нужные куски информации - ИИ генерирует ответ с учётом этих данных
Почему без RAG ничего не работает
Если просто «скормить» агенту папку с заметками:
- он не сможет их эффективно просканировать
- не поймёт, что из этого важно
- не найдёт нужное в момент запроса
- и точно не будет помнить это постоянно
Без RAG все твои данные — это просто мёртвый груз.
Ключевые компоненты RAG
Чтобы система работала, нужны три базовых элемента:
1. Хранилище данных
Где лежат твои заметки (файлы, базы, документы)
2. Векторная база данных
Она хранит не текст, а его «смысловые представления» (эмбеддинги)
3. Механизм поиска (retrieval)
Он находит наиболее релевантные куски информации и передаёт их в ИИ
В следующих разделах разберём:
- как собрать RAG своими руками
- какие есть продвинутые техники (reranking, chunking, hybrid search)
- и какие инструменты позволяют не изобретать всё с нуля
Что такое RAG (Retrieval-Augmented Generation)
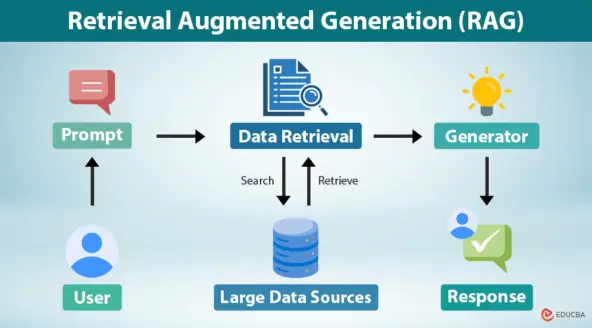
RAG (Retrieval-Augmented Generation) — это архитектурный подход, который позволяет языковым моделям (LLM) генерировать ответы не только на основе своих обученных знаний, но и с опорой на ваши собственные данные.
Проще говоря, RAG — это способ «подключить память» к ИИ-агенту через внешнее хранилище, чаще всего — векторную базу данных.
Расшифровка RAG: три ключевых этапа
Название технологии отражает её внутреннюю логику:
1. Retrieval (поиск)
Система находит релевантные фрагменты данных в векторной базе.
2. Augmented (дополнение)
Найденная информация добавляется в промпт (запрос) к модели.
3. Generation (генерация)
LLM формирует ответ, опираясь на полученный контекст.
Зачем нужен RAG
Главная проблема, которую решает RAG — ограничение контекстного окна.
Ты не можешь:
- вставить в промпт целую книгу
- загрузить огромную базу знаний
- или держать все заметки «в памяти» модели
Либо текст не поместится, либо стоимость запроса станет неадекватной.
RAG решает это элегантно:
он подгружает только те фрагменты, которые действительно нужны здесь и сейчас.
Как работает RAG: пошагово
Этап 1: Подготовка данных (Indexing)
Перед тем как система начнёт отвечать на вопросы, данные нужно подготовить.
Например, у тебя есть база заметок (тот же Obsidian vault).
Что с ней происходит:
- Текст разбивается на небольшие части — чанки (chunks)
- Каждый чанк прогоняется через embedding-модель
- На выходе получается эмбеддинг — числовое представление смысла текста
- Эти эмбеддинги сохраняются в векторную базу данных
👉 По сути: ты превращаешь текст в «координаты смысла»
Этап 2: Обработка запроса (Query processing)
Когда пользователь задаёт вопрос:
- Он тоже переводится в эмбеддинг
- Система сравнивает его с эмбеддингами чанков в базе
- Находит наиболее похожие
Это и есть семантический поиск — поиск по смыслу, а не по ключевым словам.
Этап 3: Извлечение контекста (Retrieval)
Далее:
- Выбираются наиболее релевантные чанки
- Из них извлекается исходный текст
- Этот текст добавляется в промпт
И только после этого запрос отправляется в LLM.
Что происходит дальше
Модель:
- получает вопрос
- получает релевантный контекст
- и генерирует ответ
Важно:
LLM в RAG-сценарии не “вспоминает”, а отвечает на основе подгруженных данных.
Почему RAG — это не «фича», а дисциплина
Многие думают, что RAG — это какая-то кнопка или готовый плагин.
На практике это:
полноценная инженерная дисциплина, как разработка веб-приложений или ML-систем
Нельзя просто загуглить «скачать RAG» и получить результат.
Да, существуют готовые решения, но в основе всегда лежит:
- пайплайн обработки данных
- настройка поиска
- оптимизация качества ответов
Как подключить RAG к своему ИИ-агенту
Если ты хочешь дать агенту «память», у тебя есть два пути:
1. Собрать RAG вручную
Ты сам строишь весь пайплайн:
- загрузка данных
- разбиение на чанки
- создание эмбеддингов
- настройка поиска
- интеграция с LLM
2. Использовать готовое решение
Сервисы и фреймворки, которые делают это за тебя
Собираем RAG вручную
Сразу обозначим:
смысла переписывать документацию инструментов нет.
Сегодня проще:
- загрузить доки в NotebookLM
- изучить через AI-ассистентов
- и собрать систему через vibe coding
Гораздо важнее понять фундамент:
- что именно ты строишь
- из каких компонентов это состоит
- какие инструменты для этого подходят
Главный инструмент: фреймворк LlamaIndex
Один из ключевых инструментов для ручной сборки RAG — это LlamaIndex.
Он позволяет:
- удобно работать с данными
- строить пайплайны индексирования
- подключать векторные базы данных
- настраивать retrieval-логику
- интегрировать всё это с LLM
По сути, это слой между твоими данными и моделью.
Что такое фреймворк (простое объяснение)
P.S. для не-технических читателей
Фреймворк — это набор готовых модулей с кодом, каждый из которых решает конкретную задачу.
В контексте RAG это значит:
- тебе не нужно писать всё с нуля
- архитектура уже продумана
- основные механики (поиск, обработка, интеграции) уже реализованы
Грубо говоря, вместо того чтобы собирать систему по кирпичикам, ты получаешь конструктор, заточенный под создание RAG-пайплайнов.
Почему LlamaIndex — базовый инструмент
Фреймворк LlamaIndex будет для нас центральным элементом.
Он:
- связывает все компоненты RAG между собой
- управляет данными
- помогает строить pipeline от загрузки до генерации ответа
Теоретически можно собрать весь RAG только на нём.
Но на практике такой пайплайн будет довольно базовым. Поэтому дальше мы будем усиливать каждый этап отдельными инструментами.
Три ключевых этапа RAG
Любая RAG-система держится на трёх вещах:
- Чанкинг (chunking) — разбиение текста
- Эмбеддинги (embeddings) — перевод текста в векторы
- Векторная база данных — хранение и поиск
Сейчас разберём первый и самый критичный этап.
ЧАНКИНГ (Chunking)
Это точка входа во весь RAG.
Именно от того, как ты разобьёшь данные, зависит:
- сможет ли система находить нужную информацию
- насколько точными будут ответы
- не будет ли теряться смысл
👉 Ошибка на этом этапе ломает весь pipeline.
Основные стратегии чанкинга
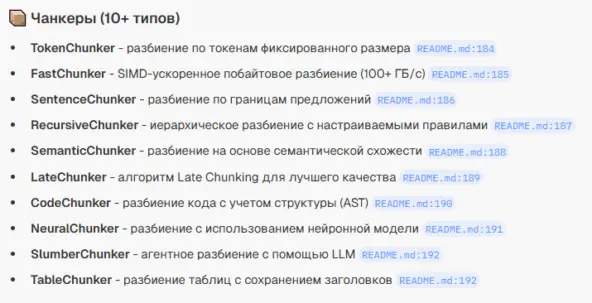
1. Size-based chunking (по размеру)
Самый простой вариант:
- текст режется на куски фиксированного размера (обычно 400–512 токенов)
- без учёта смысла
Плюсы:
- высокая скорость
- минимальные затраты
- предсказуемый размер чанков
Минусы:
- разрывает мысли
- ломает предложения и таблицы
👉 Решение: использовать overlap (перекрытие) 10–20%, чтобы сохранить контекст.
2. Recursive chunking (рекурсивный)
Один из самых популярных методов.
Текст делится по естественным границам:
- абзацы
- переносы строк
- специальные символы
Плюсы:
- сохраняет структуру текста
- не обрывает мысль
Минусы:
- зависит от качества исходной разметки
👉 Отлично подходит как дефолтный вариант.
3. Sentence-based chunking (по предложениям)
Алгоритм:
- группирует целые предложения
- пока не достигнут лимит токенов
Плюсы:
- максимально связный текст
- идеально для понимания LLM
Минусы:
- длинные предложения могут ломать баланс
- плохо работает с «грязным» текстом
👉 Хорошо подходит для:
- диалогов
- Q&A
- статей
4. Page-level chunking (по страницам)
Каждая страница документа = один чанк.
Плюсы:
- сохраняет визуальную структуру
- идеально для PDF, отчётов, презентаций
Минусы:
- непредсказуемый размер
- зависит от формата документа
5. Semantic chunking (по смыслу)
Разбиение происходит по смене темы.
Как это работает:
- текст делится на предложения
- создаются эмбеддинги
- считается «смысловое расстояние»
- при резком изменении — новый чанк
Плюсы:
- высокая точность
- лучшее понимание контекста
Минусы:
- дорого и медленно
- требует много вычислений
Продвинутые варианты:
- Кластерный чанкинг — группирует похожие куски, даже если они далеко друг от друга
- Иерархический чанкинг — создаёт структуру (главы → подглавы → детали)
6. LLM-based chunking
Здесь разбиением занимается сама языковая модель.
Она:
- анализирует структуру документа
- определяет границы
- может добавлять summary и метаданные
Плюсы:
- максимальное качество
- адаптация под сложные документы
Минусы:
- очень дорого
- долго
7. Late chunking
Один из самых продвинутых подходов.
Как работает:
- сначала анализируется весь текст целиком
- строятся связи между словами
- только потом происходит разбиение
👉 В итоге каждый чанк «понимает» весь документ.
Плюсы:
- сильно повышает точность поиска
Минусы:
- требует моделей с большим контекстом
- сложно и дорого
Какую стратегию выбрать
Логичная ошибка новичков:
«Сейчас соберу все самые умные методы — и получится идеальный ИИ»
Не получится.
👉 Универсального решения не существует.
Оптимальный выбор по умолчанию:
- Recursive chunking
- размер: 400–512 токенов
- overlap: 10–20%
Когда использовать продвинутые методы:
Если у тебя:
- большая база знаний
- сложные аналитические задачи
- корпоративный RAG (юридика, финансы и т.д.)
Важный инсайт
Свежие исследования показывают:
Простое разбиение на ~512 токенов часто даёт лучшие результаты, чем сложные стратегии.
На чём реально стоит фокусироваться
Вместо усложнения чанкинга, лучше инвестировать время в:
1. Метаданные
Добавляй к чанкам:
- теги
- даты
- категории
- источники
👉 Это сильно улучшает retrieval.
2. Очистку данных
Особенно важно для:
- сканов
- документов с мусором
Удаляй:
- лишние символы
- сломанные таблицы
- шум
Инструменты для чанкинга
Базовый вариант
LlamaIndex
Подходит для:
- старта
- простых RAG-систем
- быстрых прототипов
Продвинутый вариант
Chonkie
Почему стоит попробовать:
- очень высокая скорость
- множество стратегий чанкинга
- гибкость настройки
Практический результат
Тесты показывают:
- чанки от Chonkie дают более качественные ответы
- по метрикам (релевантность, точность, полнота) он обгоняет альтернативы
Вывод
Чанкинг — это не просто «разрезать текст».
Это:
фундамент, на котором держится весь RAG
И если сделать его правильно:
- поиск становится точнее
- ответы — качественнее
- агент — реально полезным
Стратегии чанкинга и инструменты для работы с PDF в RAG
Если в твоём RAG-пайплайне в качестве источников используются PDF-файлы (а это почти всегда так — отчёты, книги, сканы, презентации), то этап подготовки данных становится критически важным. Плохой парсинг = плохие чанки = плохой поиск.
Ниже — набор инструментов, которые реально стоит знать и использовать.
Базовый стек для обработки сканов PDF
Если у тебя PDF — это не «цифровой текст», а сканы (например, отсканированные документы или изображения), то потребуется OCR-цепочка.
Стандартный и рабочий вариант:
- pytesseract — движок для распознавания текста (OCR)
- pdf2image — превращает страницы PDF в изображения
- PIL (Python Imaging Library) — обработка изображений перед OCR
В связке они позволяют извлечь текст даже из полностью «мертвых» PDF, где обычный парсер ничего не видит.
LlamaParse (экосистема LlamaIndex)
Это встроенный парсер в LlamaIndex, который хорошо подходит для большинства задач.
Что он умеет:
- сохраняет структуру документа
- корректно обрабатывает таблицы
- понимает многоколоночную верстку
- поддерживает OCR
При этом на практике многие всё равно предпочитают использовать отдельный OCR-стек (тот, что выше), а затем уже передавать очищенные данные дальше.
В целом — хороший универсальный вариант, особенно если ты уже работаешь с LlamaIndex.
Unstructured
Мощная библиотека для извлечения текста из разных типов файлов:
- Word (DOCX)
- PowerPoint
- HTML
Главное преимущество — она извлекает не просто текст, а структурированные элементы:
- заголовки
- списки
- таблицы
Это критично для RAG, потому что структура напрямую влияет на качество чанкинга и поиска.
Дополнительный плюс — есть готовая интеграция с LlamaIndex.
Docling
По сути, альтернатива Unstructured, но:
- поддерживает больше форматов
- активно развивается
- часто используется в продакшн-сценариях
Если тебе нужно работать с разнородными источниками данных — это один из лучших вариантов.
pdfplumber
Классический инструмент для работы с PDF, но с одной очень важной фишкой:
Он извлекает текст вместе с координатами каждого слова на странице.
Зачем это нужно:
- можно показывать пользователю, где именно в документе находится ответ
- реализовать переход к конкретному месту (почти как «цитата с ссылкой»)
- улучшить UX RAG-системы
Это уже уровень выше обычного «ответа из базы» — ближе к полноценному поисковому интерфейсу.
Обогащение метаданными
Отдельно стоит отметить работу с метаданными, особенно если ты используешь markdown-заметки (например, из Obsidian).
В LlamaIndex есть встроенный парсер, который:
- сохраняет структуру заголовков
- передаёт её в метаданные чанков
- позволяет учитывать иерархию документа при поиске
В результате ты получаешь не просто куски текста, а контекстно обогащённые чанки, что напрямую влияет на качество retrieval.
Вывод по этапу подготовки данных
На практике качество RAG-системы сильно зависит не от модели, а от того:
- насколько чистые у тебя данные
- сохраняется ли структура
- добавлены ли метаданные
- правильно ли обработаны PDF и сканы
Хороший парсинг + грамотный чанкинг дают больше прироста качества, чем попытки «докрутить» модель.
Эмбеддинги (Embeddings)
Теперь переходим ко второму ключевому этапу RAG — эмбеддингам. Именно здесь текст превращается в «смысловые векторы», на которых и строится весь семантический поиск.
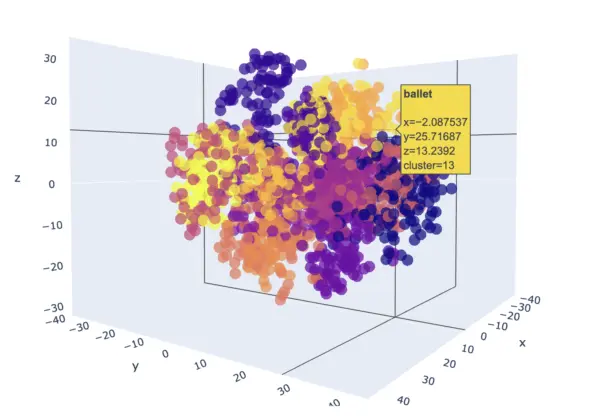
Эмбеддинги: что это и как с ними работать
Если сильно упростить, эмбеддинги (embeddings) — это способ перевести текст в числовую форму, чтобы компьютер мог сравнивать его по смыслу.
Визуально это можно представить как пространство, где:
- похожие по смыслу тексты находятся рядом
- разные — далеко друг от друга
Именно на этом строится семантический поиск в RAG.
Нужно ли заморачиваться с эмбеддингами?
Короткий ответ — нет.
На практике выбор embedding-модели редко является узким местом. Большинство современных моделей дают достаточно хорошее качество «из коробки», особенно для базовых и средних задач.
Гораздо большее влияние на результат оказывают:
- чанкинг
- качество данных
- метаданные
- стратегия retrieval
Какие embedding-модели использовать
Если ты собираешь RAG-систему, вот рабочие варианты:
1. Локальные модели (рекомендуется для старта)
paraphrase-multilingual-MiniLM-L12-v2— хороший баланс качества и скоростиnomic-embed-text— лёгкий и быстрый вариант
Плюсы:
- бесплатно
- можно запускать локально
- не зависят от API
Отдельно: Gemini Embedding 2
Есть одна модель, которая действительно выделяется — Gemini Embedding 2 от Google.
Её ключевая особенность — мультимодальность.
Она умеет превращать в эмбеддинги:
- текст
- изображения
- видео
- аудио
И самое важное — всё это попадает в единое векторное пространство.
Почему это важно
В классическом RAG тебе приходится:
- отдельно обрабатывать текст
- отдельно парсить изображения
- отдельно работать с аудио и видео
Это превращается в сложный pipeline с кучей промежуточных шагов.
С мультимодальной моделью всё проще:
любые данные сразу переводятся в единый «язык смысла»
Это сильно упрощает архитектуру системы.
Минусы
- модель платная
- требует работы через API
Небольшое наблюдение
Если говорить про мультимодальные технологии в целом, то Google сейчас действительно находится среди лидеров.
Вывод по эмбеддингам
Не стоит переусложнять этот этап.
Для большинства задач достаточно:
- взять нормальную embedding-модель
- убедиться, что она стабильно работает
- и двигаться дальше
👉 Основной буст качества ты получишь не здесь, а на этапах чанкинга и retrieval.
Векторные базы данных
Теперь переходим к третьему ключевому элементу RAG — векторным базам данных. Именно они хранят эмбеддинги и обеспечивают быстрый поиск по смыслу.
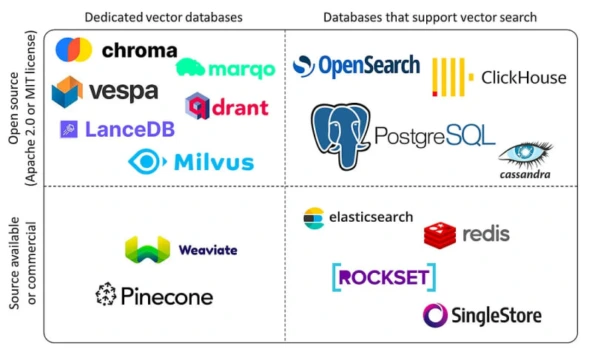
Векторные базы данных в RAG: хранение и поиск эмбеддингов
На этом этапе RAG-системы происходит самое важное с точки зрения инфраструктуры — хранение эмбеддингов и их последующий поиск.
Векторных баз данных сегодня действительно очень много, но для практики достаточно понимать базовую классификацию и несколько ключевых решений.
Какие бывают векторные базы данных
Глобально все векторные БД делятся на два типа:
Локальные и облачные.
Разница между ними не только в удобстве, но и в архитектуре.
Локальные векторные БД
Когда ты разворачиваешь базу у себя:
- все эмбеддинги хранятся в оперативной памяти (RAM)
- система работает быстро, но требует ресурсов
Главный нюанс:
Если не настроить сохранение данных, то при выключении:
- базы
- сервера
- или компьютера
👉 все эмбеддинги просто исчезнут
И тебе придётся пересчитывать их заново.
Что с этим делать
Нужно настроить персистентность (persistence) — сохранение данных на диск и их восстановление при запуске.
Это базовая, но критически важная вещь, о которой часто забывают новички.
Облачные векторные БД
В облачных решениях всё проще:
- данные хранятся на стороне провайдера
- персистентность уже настроена
- не нужно думать про инфраструктуру
Минус — за это приходится платить.
Популярные векторные базы данных
Теперь разберём несколько реально используемых решений для RAG.
Pinecone
Pinecone — одна из самых популярных облачных векторных БД.
Что даёт:
- быстрый старт без инфраструктуры
- гибридный поиск (семантика + ключевые слова)
- фильтрацию по метаданным
Подходит, если ты хочешь:
- быстро запустить продукт
- не заниматься DevOps
Минусы:
- платная
- нет локального деплоя
Qdrant
Qdrant — open-source решение, которое многие считают топом для локального RAG.
Плюсы:
- высокая производительность
- мощная фильтрация по метаданным
- гибкость настройки
👉 Отличный выбор для локального «второго мозга» или кастомных решений.
Chroma
Chroma — максимально простой и лёгкий вариант.
Плюсы:
- установка буквально одной командой
- идеален для MVP
- хорошо подходит для небольших датасетов
👉 Отличный вариант для старта и прототипов.
Milvus
Milvus — решение для больших масштабов.
Подходит, если у тебя:
- сотни миллионов или миллиарды эмбеддингов
- корпоративные задачи
- сложные мультимодальные данные
Плюсы:
- высокая производительность
- поддержка гибридного поиска
- работа с текстом и изображениями
👉 Если ты строишь enterprise-решение — это один из лучших вариантов.
pgvector
pgvector — это расширение для PostgreSQL.
Когда использовать:
- если у тебя уже есть база на PostgreSQL
- если нужно объединить классические данные и эмбеддинги
👉 Удобно, когда не хочется городить отдельную инфраструктуру.
Что выбрать на практике
Если не усложнять:
- для локальной разработки — Qdrant или Chroma
- для быстрого старта — Pinecone
- для больших проектов — Milvus
Личный практический выбор для многих разработчиков — Qdrant, потому что он даёт баланс между контролем и производительностью.
Что делать дальше
После того как ты разобрался с базовыми компонентами RAG:
- чанкинг
- эмбеддинги
- векторная БД
дальше начинается самое интересное — сборка пайплайна.
И тут происходит магия современного AI-разработчика:
Ты просто формулируешь, что хочешь получить, работаешь итерациями с ИИ (например, через Claude или другие агенты), и постепенно собираешь систему.
Даже если какие-то детали пока кажутся сложными — это нормально. На этом этапе у тебя уже есть главное:
- понимание архитектуры
- базовые термины
- представление, как всё соединяется
Этого достаточно, чтобы начать.
Какие ещё бывают виды RAG
И вот здесь начинается следующий уровень.
Классический RAG — это база. Но поверх него уже появились более продвинутые подходы.
Один из самых интересных — Graph RAG.
Graph RAG: следующий уровень памяти
Классический RAG работает с чанками текста.
Проблема в том, что:
- текст дробится
- связи между частями теряются
- глобальный контекст размывается
Если ты хочешь сделать действительно «умную» память, этого становится недостаточно.
В чём идея Graph RAG
Вместо работы с кусками текста система:
- извлекает сущности (entities)
- определяет связи между ними (relationships)
- строит граф
То есть данные превращаются не в список чанков, а в сеть взаимосвязанных смыслов.
Что это даёт
- лучшее понимание контекста
- возможность отвечать на сложные вопросы
- сохранение логических связей
👉 Это уже ближе к настоящему «второму мозгу», а не просто поиску по заметкам.
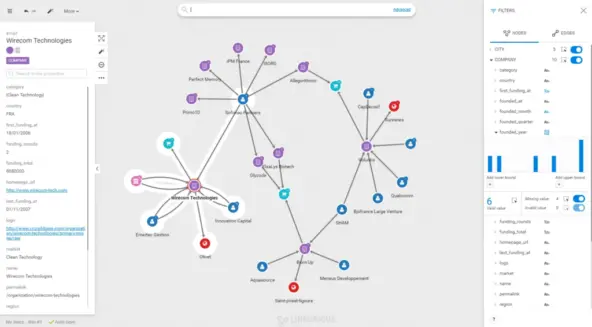
Graph RAG: как работает «память со связями»
По своей логике Graph RAG очень напоминает метод ведения заметок Zettelkasten (который популярен среди пользователей Obsidian) и в целом ближе к тому, как устроена человеческая память.
В голове факты не существуют изолированно. Например, понятие «Лондон» автоматически связано с «чаем», потому что у нас есть знание о культурных привычках англичан. Эти связи формируют контекст и позволяют быстрее находить нужную информацию.
Graph RAG пытается воспроизвести именно этот принцип. Вместо хранения разрозненных текстовых чанков система извлекает сущности и связи между ними, формируя граф знаний. Благодаря этому ИИ-агент начинает «видеть» не отдельные куски информации, а целостную картину.
Где Graph RAG действительно полезен
Этот подход особенно хорошо работает с:
- книгами
- статьями
- транскриптами
- личными заметками
- любыми связными текстами
То есть там, где важно понимать не только факты, но и их взаимосвязь.
А вот для табличных или сильно структурированных данных Graph RAG подходит хуже — там классический RAG часто эффективнее.
Важный момент про Obsidian
Если ты используешь Obsidian и думаешь, что ссылки вида [[заметка]] автоматически улучшат работу Graph RAG — это не так.
Для ИИ-пайплайна такие ссылки — это просто текст. Они не превращаются в реальные связи, пока ты явно не построишь граф через соответствующие алгоритмы.
Инструменты для Graph RAG
Если говорить про стек:
- LlamaIndex — можно использовать как базу, у него есть встроенные механики для работы с графами
- Microsoft GraphRAG — специализированный фреймворк, заточенный именно под этот подход
- Neo4j — одна из самых популярных графовых баз данных
- Gephi — инструмент для визуализации графов знаний
Если нужен серьёзный результат, лучше использовать специализированные решения вроде Microsoft GraphRAG, потому что LlamaIndex здесь скорее универсальный инструмент, а не профильный.
Agentic RAG: когда агент сам управляет поиском
Agentic RAG — это не отдельный тип RAG, а надстройка над ним.
Если в классическом варианте поиск происходит по фиксированному сценарию, то здесь ИИ-агент сам управляет процессом.
Как это работает:
- агент анализирует запрос
- строит план поиска
- вызывает разные инструменты
- оценивает найденные данные
- при необходимости корректирует запрос
- запускает новые итерации
Этот цикл повторяется до тех пор, пока система не соберёт достаточно качественный контекст.
В итоге получается не просто поиск, а итеративное мышление поверх данных.
Инструменты для Agentic RAG
Чтобы реализовать такой подход, нужны фреймворки для построения агентных систем:
- LangChain — самый популярный и универсальный вариант с большим количеством интеграций
- LangGraph — более продвинутый инструмент из экосистемы LangChain, лучше подходит для сложных сценариев с циклами, состояниями и маршрутизацией
Оба инструмента можно использовать не только для RAG, но и в целом для разработки ИИ-агентов.
Hierarchical RAG: работа с разными уровнями контекста
Hierarchical RAG решает классическую проблему:
- маленькие чанки → высокая точность, но мало контекста
- большие чанки → много контекста, но хуже поиск
Этот подход комбинирует оба варианта.
Как это работает
Документы разбиваются на несколько уровней:
- крупные (разделы, главы)
- средние
- мелкие (детальные чанки)
Эмбеддинги создаются для мелких частей, чтобы обеспечить точный поиск. Но когда система находит релевантный кусок, она подтягивает связанный с ним более крупный фрагмент.
В итоге модель получает:
- точное совпадение
- плюс широкий контекст вокруг него
Инструменты для Hierarchical RAG
В LlamaIndex уже есть готовые решения:
- RaptorPack — строит иерархию через кластеризацию и суммаризацию
- AutoMergingRetriever — объединяет мелкие чанки в более крупные при необходимости
- HierarchicalNodeParser — создаёт многоуровневую структуру документа
Готовые RAG-решения (под ключ)
Теперь к самому практическому — инструментам, которые можно просто взять и использовать.
Mem0
Готовый RAG-пайплайн с облачной архитектурой (но можно развернуть и локально).
Что внутри:
- векторный поиск (обычно через Qdrant)
- графовая структура (Neo4j)
- метаданные (PostgreSQL)
- реранкинг результатов
- автоматическое обновление памяти
Система сама:
- извлекает факты из диалогов
- решает, что сохранить
- решает, что подгрузить в контекст
Есть удобный дашборд и поддержка мультимодальности.
Важно: графовая часть здесь скорее вспомогательная, чем полноценный Graph RAG.
QMD
Локальная поисковая система для markdown-заметок.
Как работает:
- расширяет запрос синонимами через LLM
- запускает одновременно лексический и семантический поиск
- объединяет результаты через алгоритм RRF
- выдаёт топ релевантных чанков
Фишка — AST-aware chunking, который учитывает структуру markdown.
Минусы:
- высокая нагрузка на RAM
- может работать медленно
Плюс: очень качественные результаты.
OpenViking
Подход, где память представлена не как база, а как файловая система.
Контекст хранится в виде:
- файлов
- папок
- структурированных заметок
Поиск происходит по уровням:
- краткое summary
- обзор
- полный контекст
Идёт не просто поиск по смыслу, а навигация по структуре знаний.
Graphiti
Инструмент для работы с графовой памятью с учётом времени.
Фишки:
- хранит, когда появились данные
- отслеживает изменения
- позволяет анализировать историю
Поддерживает:
- семантический поиск
- графовый
- лексический
Подходит для задач, где важно отслеживать эволюцию информации (например, разработка проектов).
Hindsight
Готовое решение на базе Graph RAG.
Типы памяти:
- факты
- опыт агента
- мнения
- наблюдения
Система:
- обучается в процессе взаимодействия
- хранит временной контекст
- позволяет анализировать данные на таймлайне
Главный плюс — работает «из коробки».
Cognee
Гибкий движок знаний для ИИ-агентов.
Что делает:
- обрабатывает документы (30+ форматов)
- строит векторную базу
- извлекает сущности
- формирует граф
Есть:
- временные связи
- автоматический выбор стратегии поиска (Agentic RAG)
Главный плюс — очень быстрый деплой.
Итог
На этом этапе у тебя уже есть полная картина:
- как работает классический RAG
- как его улучшать
- какие есть продвинутые подходы
- какие инструменты использовать
И самое важное — ты понимаешь, что «память ИИ» — это не магия, а инженерная система, которую можно собрать под свои задачи.
Канал с гайдами и контентом по claude code, выкладываем новости (когда режут лимиты в 10 раз) и какие инструменты через claude реализуем для проектов, канал: https://t.me/claudedevolper