一般的な状況を想像してください:別のストリームデータプロセッサーを設定する必要があります。200ページ以上のドキュメントを開き、数十種類のソース、トランスフォーメーション、フィルター、エラー処理ポリシーが説明されています。Kafka、RabbitMQ/ArtemisMQ、GRPC、PostgreSQLなどのセクションで必要なパラメーターを探します。DSLの構文を思い出します—ただし、操作の種類によって異なります。前のプロジェクトから見つけた類似の設定を企業のGitリポジトリからコピーし、新しい要件に合わせて編集します。ドキュメントとIDEのブラウザータブを切り替えます。
claude codeのガイドとコンテンツを含むチャネル。ニュース(制限が10倍削減されたときなど)と、claudeを通じてプロジェクト用に実装するツールについて投稿します。チャネル: https://t.me/claudedevolper
これには30分から数時間かかります。そして結局のところ、構文エラーを犯したり、データソースを誤って設定したり、重要なセキュリティパラメーターを見落とす可能性があります。
では、このプロセスを30秒に短縮したらどうでしょうか?タスクを自然言語で説明するだけです—「Kafkaからのイベントをフィルタリングするプロセッサーを設定します。user_idが1000より大きく、優先度がhighのレコードのみを保持し、結果を新しいトピックに送信します」—そして、当社の製品の特性に適応した完成した設定を取得します。まだ製品に合わせる必要がある抽象的なYAMLまたはCONFテンプレートではなく、正しいパラメーター、トランスフォーメーション用の正しいDSL構文、および製品のアーキテクチャパターンに準拠し、チェックして本番環境に適用できる設定です。
この記事では、RAG(検索増強生成)、ベクトルデータベース、およびA2Aプロトコルを使用したエージェント間通信を使用して、当社の製品の1つのコンポーネント用の設定の自動生成システムを作成した方法について説明します。
問題の概要
ストリームデータ処理システムを扱うエンジニアは、毎日様々なシステム向けの設定を作成する必要性に直面しています。これはデータプロセッサー、複雑なマルチステップトランスフォーメーション、エラー処理ポリシー、サービス間のイベントルーティングルールです。同時に、各システムコンポーネントが別のセクションで説明されている数百ページのボリュームのある文書を学ぶ必要があります。
開発者は多くの形式の構文を覚える必要があります:基本的な設定用のYAML/JSON、セキュリティポリシーの説明用の特定の形式です。しかし最も難しいのは、データトランスフォーメーションを説明するためのプロプライエタリDSLの操作です。中程度の複雑さの1つの設定を作成するには、30分から数時間かかります。この間、エンジニアはタスク間を切り替え、コンテキストを失い、情報検索に気を散らします。
従来のアプローチ—前のプロジェクトからのコピーペーストと手動編集—は遅いだけでなく、エラーが起こりやすいです。パラメーター名のタイプミス、YAMLの不正なインデント、忘れられた必須パラメーター、または古い設定からの古い構文バージョンはすべて、デバッグに失われた時間に変わります。そして本番環境の話であれば、エラーのコストは非常に高くなる可能性があります。
さらに、文書は絶えず更新されます。新しいパラメーターが表示され、一部は非推奨になり、推奨事項が変わります。エンジニアは最新の変更について知らず、古いアプローチを使用する可能性があります。この問題はプロプライエタリDSLで特に深刻です:YAMLやJSONなどの標準形式とは異なり、インターネットに多くの例があるトランスフォーメーションの特定の構文は企業ドキュメントにのみ記載されています。
トランスフォーメーション用のDSLの特殊性
Platform V Synapse Streaming Event Processingでは、ストリームデータトランスフォーメーション—tr-ファイルを説明するためのプロプライエタリDSLが使用されています。これは、JavaやPythonで命令型コードを書く必要なくトランスフォーメーションを明確に説明するために特別に設計された宣言型言語です。
DSLは、フィールドマッピングを説明することができます—入力イベントの構造を必要な出力構造に変換し、フィールドの名前変更、JSONから入れ子になった値を抽出、複数のフィールドを1つに結合します。イベントのフィルタリングは、複雑な条件、論理演算子、日付、文字列、数値、正規表現を操作する機能をサポートする式によって実装されます。外部ソースからのデータエンリッチメントがあります。システムは集約ウィンドウの操作、キーによるグループ化、および集約関数の適用をサポートしています。
define isFirst = truefor ($data: in) { if ($isFirst) { out[>] = $data headers[>].TargetKey = generateId() define isFirst = false } else { out[+>] = $data headers[+>].TargetKey = generateId() } INFO("RESULT", out, "TEST.OUT", "-")}LLMの場合、このDSLは非標準です。GigaChatまたは他の公開モデルのトレーニングセットには含まれていませんでした。このモデルはPythonやSQLの場合のように単に構文を「思い出す」ことはできません。追加のコンテキストなしでtr-ファイルを生成しようとすると、ハルシネーション(幻覚)が発生します:モデルは存在しない機能を発明したり、他の類似言語の構文を使用したり、セクションの順序を混同したりする可能性があります。
だからこそRAGは単なる改善ではなく、システムの重要な必須コンポーネントになります。最新のドキュメントと例にアクセスできなければ、プロプライエタリDSLで設定を正しく生成することは不可能です。
アイデアから30秒で完成した設定へ
わずか数秒で自然言語の要件記述を正しい設定に変換するシステムを作成しました。重要な考え方は、特定のDSLで最初からモデルをトレーニングしようとするのではなく、製品ドキュメント自体を人工知能の知識源として使用することです。
プロセスは準備段階から始まります:すべての製品ドキュメントをベクトルデータベースにロードします。公式ドキュメントをMarkdown形式で取得し、特別なサービスがドキュメントを論理的なフラグメント(チャンク)に分割し、ベクトル表現(エンベディング)に変換します。このプロセスはシステムの初期セットアップ時に1回だけ実行する必要があり、その後ベクトルデータベースはドキュメントが変更された場合にのみ更新されます。
エンジニアが自然言語で設定要件を説明すると、魔法が始まります。
リクエストは簡潔で明確に書くことができます。「user-actionsトピックからイベントを読み取り、purchase型のイベントだけをフィルタリングして1000ルーブルを超える金額のものを抽出し、別のトピックのユーザーデータで情報を補強して、結果をhigh-value-purchasesトピックに送信するハンドラーを作成して」といった感じです。システムは構文やパラメーター名の正確な知識を必要としません。ドキュメントから必要な情報を自動的に見つけます。
システムはリクエストを分析し、RAGメカニズムを使用してドキュメント内の関連するコンテキストを見つけます。これはキーワードベースの単純な全文検索ではなく、意味に基づく検索です。「トピックからイベントを読む」という表現はKafkaソースに関するドキュメンテーション部分と関連していること、「purchase型のイベントのみをフィルタリング」にはフィルター設定が必要なこと、「結果をトピックに送信」するにはdestinationを設定する必要があることを理解しています。
LLMは見つかったドキュメントのフラグメントを受け取り、コンテキストを考慮した完成した設定を生成します。モデルは単にランダムにテキストを生成するのではなく、ドキュメント内の具体的な例に基づいて、正しいパラメーター名を使用し、構文に従います。
その結果得られる設定は、すぐに適用できます。追加の調整は不要です。すべての必須パラメーターは正しい値で埋められ、現在のバージョンに従った製品の設定ファイル構造の要件を満たしており、トランスフォーメーション用のDSL構文が正しく適用されています(必要な場合)。
つまり、エンジニアは製品バージョンのドキュメントを検索したり、特定のパラメーター名を思い出したり、DSLの構文の微妙な点を理解するために時間を費やす必要はありません。システムが最新のドキュメントに基づいて自動的にこれを行います。
ただし、生成は仕事の半分に過ぎません。
設定の作成中に、ジェネレーターエージェントはA2Aプロトコルを介してバリデーターエージェントを呼び出します。バリデーターエージェントは生成された設定とユーザーの元のリクエストを受け取り、その設定が実際にタスクを解決しているかどうかを確認します。すべての必須パラメーターが指定されていますか?論理エラーやパフォーマンスの潜在的な問題はありませんか?バリデーターは「設定は正しい」と答えるか、修正をリクエストできます:「filtersセクションに必須パラメーターfield_nameがありません」または「production環境ではSSL接続を追加することをお勧めします」といった形です。
エージェント同士は有効な設定が得られるまで繰り返し相互作用します。複数のサイクルがかかる可能性があります。ジェネレーターが最初のバージョンを作成し、バリデーターが問題を見つけ、ジェネレーターがコメントを考慮して修正し、バリデーターが再度チェックするという流れです。通常は1~3回の反復が必要です。このプロセスは完全に自動的で、手動デバッグの時間ではなく、わずか数秒かかります。
設定がAIチェックを通過したら、静的メソッドでさらに検証できます。Config ValidatorはYAMLの構文が正しいこと、JSONスキーマが正しいことを確認し、Kubernetesへのデプロイメント用の設定であればマニフェスト仕様に適合していることをチェックします。
正規表現を使用してカスタム検査を設定できます。例えば、トピック名が企業の命名規約(naming convention)に準拠していることを確認できます。完成した結果は、組み込みのデプロイメントメカニズムを使用してクラスターに直接適用するか、既存のCI/CDパイプラインにコピーして使用できます。
ベクトルデータベース:AIがドキュメントを理解する仕組み
エンベディングとは何か
エンベディングは、テキストを固定長の数値ベクトルとして表現する方法です。通常、モデルに応じて384から1536の次元があります。
このベクトル内の各数値は多次元空間の座標であり、点の位置はテキストの意味論的な意味を反映しています。エンベディングの重要な特徴は、意味論的に類似したテキストが近いベクトルを持つこと、そしてベクトル間の距離またはコサイン類似度を計算してテキストを見つけることができることです。
例えば、ドキュメントから3つのフレーズを考えてみましょう。「Kafkaソース」はベクトル [0.82, -0.33, 0.15, 0.67, ...] として表現できます。「Kafka input」はベクトル [0.81, -0.35, 0.14, 0.65, ...] で表現され、「メッセージキューから読み取る」は [0.77, -0.33, 0.14, 0.63, ...] で表現されます。
3つのフレーズすべてはメッセージブローカーからデータを取得する概念について説明しており、それらのベクトル表現は多次元空間で互いに近くなります。最初のベクトルと2番目のベクトルの間の距離は小さいですが、最初のベクトルと「ネットワークポリシーの設定」のような全く関連のないフレーズとの間の距離ははるかに大きくなります。
エンベディングが単に共通の単語の数をカウントしているわけではないことを理解することが重要です。エンベディングを作成するモデルは膨大なテキスト量で訓練され、コンテキスト、シノニム、概念間の関係を理解しています。したがって、「Kafka source」と「トピックから読み取る」は共通の単語がなくても、類似したエンベディングを持つことになります。
ドキュメンテーションのインデックス化
ドキュメントをシステムに読み込むときに、いくつかの重要な処理段階が発生します。
まず、ドキュメントは意味のあるフラグメント、つまりチャンクに分割されます。これは非常に重要なステップです。分割の品質は検索の品質に直接影響するからです。チャンクが小さすぎるとコンテキストを失い、大きすぎると非特異的になり、複数の無関連のトピックを含む可能性があります。
チャンクサイズは、ドキュメンテーションの特性に応じて調整します。短いパラメーター説明を含むリファレンスドキュメンテーションの場合、最適なサイズは256~512トークンです。チャンク間でオーバーラップを使用し、サイズはチャンクサイズの10~20%です。これは、1つのチャンクの最後のいくつかの文が次のチャンクの開始時に繰り返されることを意味します。なぜですか?境界にコンテキストを保持するためです。概念の説明がチャンク間の境界に落ちた場合、このオーバーラップはその説明がいずれかのチャンクで完全に表現されることを保証します。
各チャンクはSberのEmbeddingsモデルを使用してベクトルに変換されます。このモデルを選択した理由は、ロシア語で特別に訓練されており、ロシア語の技術テキストの高品質な意味論的表現を生成するからです。モデルは特定の用語、略語、技術的なジャーゴンを理解しています。
ベクトル表現はPlatform V Vector DB(高性能なセマンティック検索用に設計された専門的なベクトルデータベース)に保存されます。ベクトルとともに、フラグメントの元のテキストとメタデータ(ドキュメントソース、セクション、更新日付、タグ(例えばkafka、filters、security))も保存します。これにより、フィルターを使った正確な検索が可能になります。例えば、Kafkaに関するマテリアルだけ、またはセキュリティに関連するセクションだけを検索できます。
例えば、ネットワークポリシー設定規則を含むドキュメントは次のように分割できます。チャンク「デフォルトで全受信トラフィックを拒否」はベクトル [0.76, -0.21, 0.94, ...] とメタデータ {source: "network-policy.yaml", section: "ingress-rules", tags: ["security", "network"]}を取得します。次のチャンク「frontendのネームスペースからのポート80のみを許可」は独自のベクトル [0.68, -0.19, 0.91, ...] と同様のメタデータを取得します。「フロントエンドのみがサービスにアクセスするよう設定」というクエリで検索する場合、システムは両方のチャンクを関連するものとして見つけます。この場合、2番目のチャンクはより高いスコアを取得します。
RAG: Retrieve-Augment-Generate
なぜシンプルな LLM の使用だけでは私たちのタスクに十分ではないのかを理解しましょう。GigaChat、GPT、Claude などのような最新の言語モデルは、テキスト生成と文脈理解において素晴らしい能力を持っています。しかし、それらには根本的な制限があります。
まず第一に、モデルはあなたのドキュメンテーションの特殊性を知らない可能性があります。GigaChat は公開インターネットデータで訓練されていますが、Platform V Synapse Streaming Event Processing、プロプライエタリー DSL、および企業標準に関する私たちの内部ドキュメンテーションは訓練データに含まれていませんでした。
第二に、モデルの知識は訓練日に限定されています。最後の訓練が半年前に行われ、その間に新しいパラメータを含む 3 つの製品アップデートがリリースされた場合、モデルはそれについて知りません。
第三に、モデルは「幻覚」を見ることができます。存在しないパラメータを作り出したり、異なるバージョンの構文を混ぜたり、もっともらしく聞こえるが不正な設定を生成したりすることができます。
RAG(Retrieval-Augmented Generation)は、モデルが訓練中に得られた知識のみに依存するのではなく、まず外部ソース(この場合、ドキュメンテーションを含むベクトルデータベース)から現在のコンテキストを取得するアーキテクチャパターンです。これは根本的にアプローチを変えます。モデルは知識の源ではなく、ユーザーのクエリを理解し、見つかったフラグメントから情報を正しく適用できるドキュメンテーションのインタープリタになります。
RAG の 3 つのステージ
Retrieve(検索)。ユーザーがクエリを入力する場合、システムはすぐにそれを LLM に送信しません。まず、クエリがベクトル化されます。つまり、ドキュメンテーションのインデックス作成に使用されたのと同じ Embeddings モデルを使用してエンベディングに変換されます。クエリベクトルが得られます。次に、システムはベクトルデータベースで最も似たベクトルを持つチャンクを検索し、クエリベクトルとデータベース内のすべてのチャンクのベクトル間のコサイン類似度を計算します。
これはセマンティック検索です。単語の正確な一致で検索するのではなく、意味で検索します。例えば、「昨日の日付より大きいタイムスタンプフィールドでイベントをフィルタリング設定」というクエリは、ドキュメンテーションが「時間フィルタリング」、「時間によるカットオフ」、「filter by time field」、または異なるフィールド名の例を使用していても、関連するフラグメントを見つけます。モデルは、これらのフレーズがすべてセマンティック的に類似していることを理解しています。
システムは、通常 K=3-5 の最も関連性の高い上位 K 個のチャンクを返します。多いほど必ずしも良いとは限りません。過度なコンテキストはモデルを混乱させる可能性があり、プロンプト内のトークンを増やしてコストと処理時間が増加し、関連性の低い情報が含まれる可能性があります。私たちは、システムの最適な値を実験的に選択しました。
Augment(拡張)。見つかったチャンクは単に連結されるのではなく、構造化され、フォーマットされます。複数のセクションで構成されるプロンプトが形成されます。System_prompt はエージェントの役割と動作ルールを定義します。以下はシステムプロンプトの一部です。
あなたは Cloud Event Processing の設定ファイルと DSL トランスフォーメーションジェネレータであり、仕様と提供されたコンテキストに厳密に従って動作します。主要な要件:このプロンプトからのみ情報を使用してください。仕様またはコンテキストに従った構文的かつセマンティック的に有効な設定と DSL ファイルのみを生成してください。すべての必須フィールドが入力されている必要があります。必須フィールドを正しく入力できない場合はファイルを生成しないでください。仕様またはコンテキストで説明されていない構造、ブロック、パラメータ、関数、またはシンタックスを使用しないでください。逸脱はエラーです。どのファイルにも説明、解説、コメント、または架空の要素を追加しないでください。複数のファイルが必要な場合(例えば config と transform)はそれぞれを名前と拡張子を指定して個別のブロックで出力してください。生成品質の向上のため context フィールドで提供された情報を使用してください。ファイル名と拡張子はブロックの最初の行です。名前の重複は許可されていません。
Context には、ドキュメンテーションから取得した関連フラグメントが、特別な方法でフォーマットされて含まれています。各フラグメントは、ソースを示すヘッダーで始まります。例えば、「セクション「Kafka ソース設定」から」、「ドキュメンテーション例」、「ベストプラクティス」のようなものです。これはモデルが情報がどこから来たのか、どのように解釈すべきかを理解するのに役立ちます。コード例が見つかった場合は、コメント付きで全体が含まれます。
User_request は、ユーザーの元のクエリであり、明確性のために若干言い換えられる場合があります。例えば、ユーザーが「前回のようにハンドラーを作成してください、ただし別のトピック用に」と書いた場合、システムは詳細の確認を求めることがあります。
Generate(生成)。完全に形成されたプロンプトが GigaChat に送信されます。重要な点として、私たちは特定の生成パラメータを使用しています。Temperature(温度)は約 0.5 という相対的に低い値に設定されており、これにより生成がより決定論的で予測可能になり、コードと設定の生成に重要です。高い温度(0.8~1.0)は創造的なタスクには適していますが、私たちの場合はシンタックスの「創造的解釈」につながる可能性があります。
LLM は、YAML/JSON 形式と設定の一般原則に関する基本知識と、ドキュメンテーションから提供されたコンテキストの両方に基づいて回答を生成します。これにより、設定が現在の製品仕様に合致し、正しいパラメータ名を使用し、API バージョンに準拠し、優れたエンタープライズプラクティスに従うことが保証されます。
ソリューションのマイクロサービスアーキテクチャ
システムは独立したマイクロサービスのセットとして構築されており、柔軟性、スケーラビリティ、およびシステム全体を停止することなく個々のコンポーネントを更新する機能を提供します。
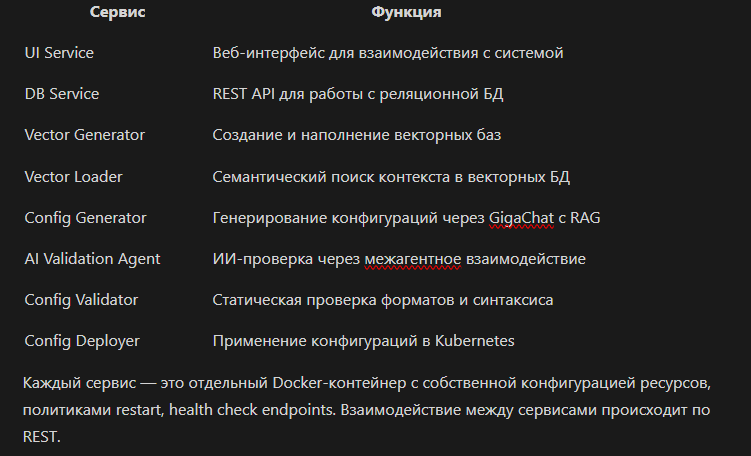
各サービスは、独自のリソース設定、再起動ポリシー、ヘルスチェックエンドポイントを備えた個別の Docker コンテナです。サービス間の相互作用は REST を介して行われます。
UI Service
これはエンジニア向けの単一エントリーポイントです。設定との作業の完全なライフサイクル管理を提供します。これは実装の 1 つのバリアントに過ぎず、システムは他のサービスに REST API を介して直接アクセスし、既存の CI/CD プロセスに統合できるように設計されています。
例えば、Jenkins パイプラインを設定して、Git リポジトリからのパラメータに基づいて Config Generator API を呼び出し、構成を自動的に生成し、Config Validator を通じて結果を検証し、Config Deployer を通じて適用することができます。インターフェイスはインタラクティブな作業のための表現層ですが、必須要素ではありません。
DB Service
これはシステムメタデータの中央リポジトリであり、データベースと連携するための REST API です。データベースはさまざまなタイプの構成のためのシステムプロンプトを保存しています。各構成タイプには、モデルへの指示、望ましい出力形式の例、必須および任意のパラメータのリストを含む、独自の最適化されたプロンプトがあります。
検証ルールは構造化された形式で保存されます。これには、名前を検証するための正規表現パターン、数値パラメータの範囲、列挙型フィールドの許可値リストが含まれます。デプロイメント用テンプレートは、Kubernetes マニフェスト用の Jinja2 テンプレートであり、生成された構成を置換するためのプレースホルダーを含みます。
ベクトルベースのメタデータには、ベース名、説明、作成日、チャンク数、使用中の埋め込みモデル、チャンキングパラメータ (サイズ、オーバーラップ)、ステータス (有効/無効)、フィルタリング用タグが含まれます。
生成履歴は完全にログされます: リクエストタイムスタンプ、user_id、リクエストテキスト、構成タイプ、使用されたベクトルベース、見つかったコンテキスト、生成された構成、検証結果、デプロイメントステータス (適用された場合)。このデータはシステムの動作品質分析とその改善に非常に貴重です。
Vector Generator
これは文書用の ETL パイプラインです。非構造化テキストをベクトル表現に変換して検索可能な埋め込みを作成することで、ベクトルナレッジベースの作成と充実を担当しています。
プロセスはベクトルベースの作成から始まります。Platform V Vector DB で指定されたパラメータを使用して、新しいベース (コレクション) を初期化します。その後、ドキュメント処理が続きます。形式の自動検出と解析を通じて、様々な形式のファイルをロードします。
次に、チャンクへの分割が行われます。各ベクトルベースのサイズは個別に設定されます — 256 または 512 トークンです。オーバーラップ (overlap) も設定されます: 通常はチャンクサイズの 10-20% ですが、相互参照の例が多い技術ドキュメントの場合は 30% まで増加する可能性があります。その後、埋め込みが生成されます。
メタデータ同期は最終段階であり、ベクトルベースに関する情報が DB Service に登録され、他のコンポーネントで今後使用できるようになります。また、Vector Generator は既存のベースをインクリメンタルに更新できます。新しいドキュメントを追加し、変更されたドキュメント (コンテンツハッシュによって) を更新し、古いドキュメントを削除できます。これにより、完全な再インデックスなしにベクトルベースを最新の状態に保つことができます。
Vector Loader
RAG 実装のための重要なコンポーネント。ユーザー要求とドキュメンテーション間のブリッジです。このサービスは複数の同時リクエストを並行して処理できます。
処理は DB Service からアクティブなベクトルベースをリクエストすることで始まります。どのベースを特定の構成タイプに使用するかをフィルタリングできます。例えば、Kafka ソースを生成する場合は、「kafka」および「sources」タグを持つベースのみを検索し、関連性のないベースを無視します。
コンテキスト形成は、元のリクエストとの類似度スコア (similarity score) に基づいて、上位 5 つのチャンクから構成されます。
結果は、プロンプトに代入する準備ができた、メタデータ付きの順序付きチャンクのリストです。
Config Generator
これはシステムの中核であり、生成プロセス全体のオーケストレーターです。GigaChat API と連携するための非同期サービスです。ユーザーからのリクエスト (インターフェイス経由または API 経由) を受け取ると、ワークフローが起動します。最初に Vector Loader が自動的に呼び出されて、関連するコンテキストを取得します — これは同期呼び出しであり、Config Generator は結果を待ちます。その後、生成する構成のタイプに固有のシステムプロンプトが DB Service から読み込まれます。
システムプロンプト、コンテキスト、およびユーザーリクエストを組み合わせた完全なリクエストが形成されます。ここで順序が重要です: システムプロンプトがロールとルールを設定し、コンテキストが知識を提供し、最後にユーザーリクエストが具体的なタスクを指定します。これにより、モデルは情報を適切に優先順位付けできます。
リクエストは生成パラメータの構成と共に GigaChat に送信されます。
生成された構成を受け取った後、Config Generator はそれをユーザーに即座に返しません。代わりに、検証が自動的に開始されます。このプロセスで、Config Generator はマルチエージェントシステムのコーディネーター役を果たし、A2A プロトコルを使用して AI Validation Agent との相互作用をサポートします。これはコールバック付きの非同期プロセスです。Config Generator は検証用に構成を送信し、結果の通知を購読します。
AI Validation Agent
これはシステム内の 2 番目の AI エージェントであり、検証に特化しています。重要な側面: これは Config Generator の一部ではなく、独自のプロンプトとモデルを備えた個別のサービスです。なぜですか? 生成と検証のタスクは異なるアプローチ、異なるプロンプト、異なるモデルパラメータを必要とするためです。
エージェントは A2A プロトコルを使用して検証リクエストを受け取ります。これには、生成された構成、元のユーザーリクエスト、およびドキュメントのコンテキスト (生成時に使用されたのと同じチャンク) が含まれます。これは重要です: 検証者は同じコンテキストを参照して、抽象的な「正しさ」の概念ではなく、現在のドキュメントに対する正確性を評価できる必要があります。
複数のタイプの分析が実行されます。正確性分析は、構成が実際に設定されたタスクを解決するかどうかをチェックします — ユーザーが「user_id > 1000 でフィルタリング」をリクエストした場合、構成に対応するフィルタがありますか? パラメータは正しく指定されていますか? 完全性分析は、すべての必須パラメータが指定されていることを確認します: 各構成タイプには必須フィールド付きのスキーマがあり、検証者がそれをチェックします。
スタイル分析は、ベストプラクティスと企業標準への準拠をチェックします — 例えば、推奨デフォルト値が使用されているか、サイバーセキュリティ要件に従ってすべての必要なフィールドが設定されているか、ログが有効になっているかなどです。これは簡単なチェックです: 構成は技術的に正しい場合がありますが、企業の標準に準拠していない場合があります。検証者はこれを警告として (エラーではなく) マークします。
セキュリティ分析 — 最も重要な分析の 1 つ — 潜在的な問題を特定します: データ転送に TLS が使用されているか、構成にハードコードされたシークレットがないかどうか。検証者は安全でない構成のパターンを認識するようにトレーニングされています。
エージェントは構造化されたレスポンスを返します: 全体的な判断 (valid, invalid, warning)、信頼度指標 (エージェントの評価に対する確実性、0から100の間)、問題のリスト (各問題に優先度を指定: error, warning, info、構成内の位置、問題の説明) および改善のための一般的な推奨事項。エラーが見つかった場合、Config Generatorは見つかった問題の説明を含めて自動的に再生成をリクエストできます (「前のバージョンではエラーXがありました、修正してください」)。
Config Validator
これはAI Validation Agentと並行して動作する、構文エラーとスキーマ違反からの保護レイヤーです。AIを使わない従来のバリデータですが、同等に重要です。
YAML-/JSON-形式の確認にはyamllintと組み込みPythonパーサーを使用し、詳細なエラーメッセージを提供します — 単に「invalid YAML」ではなく「line 15, column 3: expected indentation of 2 spaces but found 4」のような形です。Kubernetesマニフェストの確認はKubernetes APIの仕様への準拠を検証します: apiVersionが正しく指定されているか、そのようなkindが存在するか、すべての必須フィールド (required fields) がmetadata/specに存在しているかを確認します。
特定パターン用のRegex確認: 「トピック名は^[a-z0-9-]+$パターンに準拠する必要があります」、「ポートは1024-65535の範囲内である必要があります」、「namespaceはproduction用に'default'にはできません」のようなルールを設定できます。Kubernetesでのdry-run — 実際に適用する前の最終確認: マニフェストをKubernetes APIにフラグ dryRun=true で送信し、APIは実際のリソース作成なしに正確性を確認します。
すべての確認結果は、指摘のタイプ別の分類と修正への推奨事項を含む単一のレポートに統合されます。
Config Deployer
チェーンの最終段階であり、Kubernetesへの構成の安全なデプロイを担当します。
システムは2つの動作モードをサポートしています。マニフェストの直接生成モードでは、モデルは直ちにDeployment、Service、ConfigMapの完全な仕様とすべての必須フィールドを備えた準備完了のKubernetesマニフェストを作成します。これは高速ですがより柔軟性が低いです。テンプレート化モードでは、コーポレート標準を備えた事前に準備されたマニフェストテンプレートを使用します: モニタリング用のlabels、service mesh用のannotations、imagePullSecrets、resource requests/limits、liveness/readiness probes。LLMは構成の業務ロジック (例えば、アプリケーション設定) のみを生成し、これはテンプレートに代入されます。
第2のアプローチは、デプロイの一貫性、企業ポリシーの遵守、既存インフラとの統合を保証します。テンプレート作成メカニズムの基盤はJinja2で、特定のケースを処理するためのカスタムフィルタと関数があります。
システムの完全な動作サイクル
実際の例で、リクエストから適用された構成への詳細なパスを追ってみましょう。
ユーザー — エンジニアのアレクセイは次のタスクを受け取りました: Kafkaソースからのイベントをフィルタリングするハンドラを設定する必要があり、user_idが1000より大きく、優先度がhighのイベントのみを保持し、結果を今後の処理のための新しいトピックに送信します。以前、アレクセイはドキュメントを開き、Kafka sourceの構成例を見つけ、次にフィルタについてのセクション、destinationについてのセクションを見つけ、すべてをまとめていたでしょう。
今、アレクセイは単にシステムのインターフェースを開き、構成タイプCloud Event Processingを選択し、テキストフィールドに入力します: 「Kafkaソースのトピック user-eventsからイベントをフィルタリングするためのハンドラを設定し、user_id > 1000 および priority == 'high'のイベントのみを保持し、結果をトピック high-priority-usersに送信します」。「生成を実行」をクリックします。
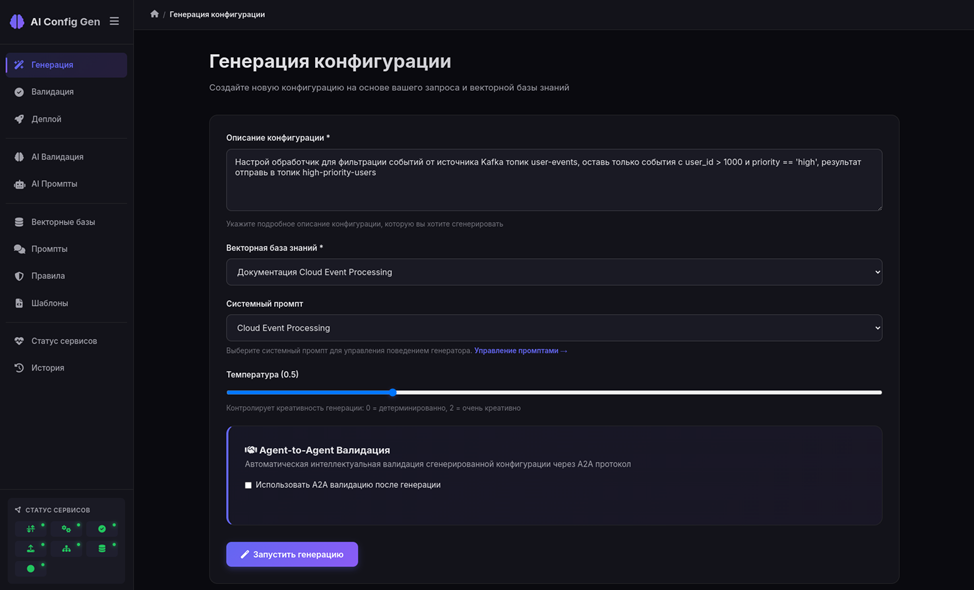
Vector LoaderはリクエストをEmbeddingsを通じてベクトル化し、ベクトルデータベースで検索します。トップ5のチャンクを見つけます: 「bootstrap serversおよびtopicを指定する例を含むKafkaソースの構成」、「数値フィールド用のfilter expressionの構文」、「文字列フィールドおよびenum values用のfilter expressionの構文」、「複数のフィルタを組み合わせる例」、「Kafkaトピックへの書き込み用のdestination構成」。これらのチャンクは、それぞれ0.89、0.87、0.85、0.82、0.79の類似度係数でConfig Generatorに返されます。
Config GeneratorはDB Serviceからシステムプロンプトを取得します。これには指示が含まれています: 「CONF形式で構成を生成します。構造: source, aggregationStep, transformStep, destination。例からの正確な構文を使用します。存在しないパラメータを作り上げないでください」。プロンプト、コンテキスト、ユーザーリクエストを組み合わせ、完全なプロンプトを形成します。
GigaChat APIに慎重に選択された生成パラメータで送信します。Temperature=0.5。なぜこの値が選ばれたのかについては上記で説明しました。ただし、モデルに別のパラメータ — max_tokens (値は1500) を渡します。これは応答の長さを制限します。中程度の複雑さの構成の場合、これで十分です: 典型的なCloud Event Processing構成は約300トークンを占めます。コメントとモデルからの可能な説明のための予備が必要です。制限が小さすぎる場合 (500-800)、複雑な構成を途中で切り取られます。大きすぎる場合 (3000+)、モデルは過剰なコンテンツを生成できます: 追加の例、説明、代替オプション。これは結果の解析を困難にします。
Config GeneratorはA2Aプロトコル経由で、この構成をAI Validation Agentに自動的に送信します。バリデータは元のリクエストと見つかったドキュメントのコンテキストでそれを分析します。確認します: user_id > 1000でのフィルタがありますか? はい。priority == 'high'でのフィルタがありますか? はい。Destinationは正しいトピックを指しています? はい。すべての必須フィールドが存在していますか? sourceを確認します (type, config.bootstrap_servers と config.topic があります)、transformStep (構造は正しい)、destination (type と config があります) — すべてそろっています。
バリデータは、固定アドレスの代わりにプレースホルダー ${KAFKA_BOOTSTRAP} が使用されていることに注意します — これは会社の標準に準拠し、ポジティブなものとしてマークします。セキュリティを確認します: 認証情報が平文で公開されていませんか? いいえ。重複処理を避けるために group_id が使用されていますか? はい。信頼度指標は0.94として計算されます (非常に確実)。
バリデータは判決を返します: {status: "valid", confidence: 0.94, issues: [], recommendations: ["失敗メッセージに対するエラー処理ポリシーの追加をご検討ください"]}。
Config Generatorはポジティブな判決を受け取り、静的確認のためにConfig Validatorを起動します。Validatorはスキーマに従って、生成されたCONFファイルの静的バリデーションを実行します。
インターフェースで、アレクセイは生成された構成に緑色のチェックマーク「Validated」と情報ヒントとしての推奨事項を見ます。構成は正しく見えます。アレクセイは「構成を名前空間に設定」をクリックします。
Config Deployerはリクエストを受け取り、DB ServiceからCloud Event Processingコンポーネント用のKubernetesマニフェストテンプレートをロードし、生成された設定をデプロイメント用テンプレートに代入します。Kubernetes APIを通じてdry-runを実行します。APIは成功を返し、マニフェストが正しく受け入れられます。Deployerが設定を適用すると、Kubernetesがリソースを作成し、Cloud Event Processingコンポーネントを持つPodが起動します。Config Deployerはステータスを監視します。Podが実行状態に遷移するのを待ち、readiness probeをチェックします。15秒後、Podの準備が完了し、ヘルスチェックが緑色です。Deployerはレコードを保存します。DB Serviceに:applied successfully、タイムスタンプ、ユーザー:Alexey、namespace:dev、および生成されたマニフェスト。
インターフェースでAlexeyは「dev namespaceへ正常にデプロイされました」、緑色のインジケーター、Kubernetes dashboardのPodへのリンクを確認できます。リクエストから稼働中の設定まで、クラスタで30秒経過しました。Alexeyはニッコリしてモニターを見ています。
プロプライエタリDSLへの対応方法
記事の最初に触れたtr-ファイル(変換用のプロプライエタリDSL)との連携という問題に戻りましょう。DSLの例のベクトル化の技術的実装には、独自の特性があります。
ベクトルデータベースでは、単なるドキュメントのテキストではなく、特別に構造化された例を保存します:完全に動作するtr-ファイル、アノテーション付きの意味的ブロックに分割されたもの(例:「時間ウィンドウを使った集計の例」)、不明な構文を説明するコメント、および典型的な使用パターンとそのバリエーション。各例は小さなチャンクに分割されることなく、全体としてベクトル化されます。これはコードの構文的完全性を保つために重要です。
ユーザーが変換の生成をリクエストするとき、Vector Loaderはタスクの意味的類似性によって、最も関連性のあるtr-ファイルの例をいくつか検出します。LLMはプロンプトで完全な例を受け取り、それらをテンプレートとして使用して、特定のリクエストに合わせて構文を調整します。これはRAGのコンテキストにおけるfew-shot learning技法です:モデルは実行中に例から学習し、再トレーニングは不要です。
結果として、モデルのトレーニングデータセットに存在しないプロプライエタリ言語でtr-ファイルを高い精度で生成できます。
セキュリティとプライバシー
企業ドキュメントおよび本番環境の設定を扱う場合、セキュリティに関する厳格な要件が課せられます。すべてのドキュメントは、クラウドのどこかではなく、企業の境界内のプライベートベクトルデータベースに保存されます。機密データを外部APIに送信することはありません。AI Validation Agentは、設定内の潜在的な機密情報漏洩を検出し、セキュリティ問題としてマークするようにも訓練されています。
まとめ
ストリーミングデータ処理設定の自動生成のためのエンドツーエンドソリューションを構築しました。これは設定作成時間を数時間から数秒に短縮し、自動検証によってコピー&ペーストエラーとタイプミスを排除します。RAGを通じてドキュメントからベストプラクティスを自動的に適用し、静的チェックとインテリジェントなAIチェックの2段階検証を実現し、拡張性のための標準A2Aプロトコルによるマルチエージェント相互作用をサポートしています。
RAGはプロプライエタリDSLの設定生成に最適なソリューションであることが判明しました。モデルがトレーニングデータセットに存在しない最新かつ具体的なドキュメントを使用できるようにします。ドキュメント内の実例に基づいているため、ハルシネーションのリスクを軽減します。簡単に更新できます。モデルの再トレーニングなしに、新しいバージョンのドキュメントをベクトルデータベースにアップロードするだけです。あらゆるタイプの設定とDSLにスケーリング可能で、汎用的なアプローチです。
プロジェクトのキーテクノロジー:生成のコンテキスト化のためのRAG、意味的検索のためのPlatform V Vector DBベクトルデータベース、ロシア語の技術テキストの高品質エンベディング作成のためのEmbeddings、生成と検証のメインLLMとしてのGigaChat、マルチエージェント相互作用と拡張性のためのA2Aプロトコル、柔軟性とスケーラビリティのためのマイクロサービスアーキテクチャ。
Claude Codeに関するガイドとコンテンツを扱うチャネル。ニュース(リミットが10倍削減されたときなど)やClaudeを通じてプロジェクト用に実装するツールについて投稿しています。チャネル:https://t.me/claudedevolper