想象一个典型的场景:你需要配置另一个流数据处理器。你打开包含200多页的文档,其中描述了数十种数据源、转换、过滤器和错误处理策略。你在Kafka、RabbitMQ/ArtemisMQ、GRPC、PostgreSQL等章节中寻找所需参数。你回忆DSL的语法——但它因不同的操作类型而异。你从公司Git存储库中的上一个项目复制相似的配置,并根据新要求进行编辑。你在文档浏览器标签页和IDE之间来回切换。
包含claude code指南和内容的频道,我们发布新闻(当限制被削减10倍时)以及我们通过claude为项目实现的工具,频道:https://t.me/claudedevolper
这需要30分钟到几小时的时间,最后你仍然可能在语法中犯错、错误配置数据源或遗漏重要的安全参数。
如果我们能把这个过程缩短到30秒呢?只需用自然语言描述任务——"配置一个处理器来过滤来自Kafka的事件,只保留user_id大于1000且优先级为high的记录,将结果发送到新的主题"——然后获得一个适配我们产品特性的现成配置。不是那种抽象的YAML或CONF模板,还需要为产品调整,而是一个具有正确参数、正确的转换DSL语法、遵守产品架构模式的配置,可以直接审核和在生产环境中应用。
在本文中,我将介绍我们如何使用RAG(检索增强生成)、向量数据库和A2A协议的多智能体交互为我们产品的某个组件创建自动配置生成系统。
关于问题的简述
与流数据处理系统一起工作的工程师每天都需要为各种系统创建配置。这包括数据处理器、复杂的多步骤转换、错误处理策略、服务间事件路由规则。与此同时,他们必须研究数百页的庞大文档,其中系统的每个组件都在单独的部分中描述。
开发人员必须记住众多格式的语法:用于基本配置的YAML/JSON、用于描述安全策略的特定格式。但最困难的是使用专有DSL来描述数据转换。创建一个中等复杂度的配置需要30分钟到几小时的时间。在此过程中,工程师在任务之间切换,失去上下文,分心于搜索信息。
经典方法——从之前的项目复制粘贴并手动编辑——不仅速度慢,而且容易出错。参数名中的每个拼写错误、YAML中的缩进错误、遗漏的必需参数或来自旧配置的过时语法版本都会导致浪费时间进行调试。如果涉及生产环境,错误的代价可能非常高昂。
此外,文档不断更新。新参数出现,一些参数变得deprecated,建议也会改变。工程师可能不知道最新的变化,可能使用过时的方法。对于专有DSL来说,这个问题尤其严重:与YAML或JSON等标准格式不同,后者在互联网上有许多示例,转换的特定语法仅在公司文档中描述。
转换DSL的特殊性
Platform V Synapse Streaming Event Processing使用专有DSL来描述流数据转换——tr文件。这是一种声明式语言,专门开发用于清晰地描述转换,而无需用Java或Python编写命令式代码。
DSL允许描述字段映射——将入站事件的结构转换为所需的输出结构,包括重命名字段、从JSON中提取嵌套值、将多个字段合并为一个。事件过滤通过支持复杂条件、逻辑操作符、用于处理日期、字符串、数字、正则表达式的函数的表达式来实现。支持来自外部源的数据丰富。系统支持与聚合窗口一起工作、按键分组和应用聚合函数。
下面是这个DSL中简单转换的示例:
define isFirst = truefor ($data: in) { if ($isFirst) { out[>] = $data headers[>].TargetKey = generateId() define isFirst = false } else { out[+>] = $data headers[+>].TargetKey = generateId() } INFO("RESULT", out, "TEST.OUT", "-")}对于LLM来说,这个DSL是非标准的,它不在GigaChat或其他公共模型的训练集中。该模型不能像Python或SQL那样简单地"记住"语法。尝试在没有额外上下文的情况下生成tr文件会导致幻觉:模型可能会编造不存在的函数、使用来自其他类似语言的语法、混淆部分的顺序。
这正是RAG不仅是改进,而是系统中至关重要的组件的原因。如果没有访问当前文档和示例的权限,就不可能正确生成专有DSL上的配置。
从想法到30秒内完成的配置
我们创建了一个系统,可以在几秒钟内将自然语言的需求描述转换为正确的配置。关键思想是使用产品文档本身作为人工智能的知识来源,而不是尝试从零开始在特定的DSL上训练模型。
该过程从准备阶段开始:将所有产品文档加载到向量数据库中。我们采用Markdown格式的官方文档,一个特殊的服务将文档分解为逻辑片段(chunks),并将它们转换为向量表示——嵌入。这个过程只需在系统的初始设置时执行一次,之后向量数据库仅在文档更改时更新。
工程师用自然语言描述配置要求,然后魔法开始了。
请求可以用简单明了的方式表述:「创建一个处理程序,从 user-actions 主题读取事件,仅过滤金额超过 1000 卢布的 purchase 类型事件,使用来自附加主题的用户数据丰富事件,并将结果发送到 high-value-purchases 主题」。系统不需要了解确切的语法或参数名称——它会自动从文档中找到所需的信息。
系统分析请求,通过 RAG 机制在文档中找到相关上下文。这不是简单的按关键词进行全文搜索,而是按语义进行语义搜索。系统理解「从主题读取事件」与 Kafka 源的文档部分相关,「仅过滤 purchase 类型事件」需要配置过滤器,「将结果发送到主题」涉及 destination 的配置。
LLM 获取找到的文档片段,并根据上下文生成现成的配置。模型不是随意生成文本——它依赖于文档中的具体示例,使用正确的参数名称,遵守语法。
最终得到的配置可以直接使用,无需额外修改,所有必需参数都填入了正确的值,符合产品根据当前版本对配置文件结构的要求,应用了 DSL 转换的正确语法(如果需要)。
这意味着工程师不需要花时间查找产品版本文档、记住特定的参数名称或理解 DSL 语法的细微差别:系统基于最新的文档自动完成这一切。
但生成只是一半的工作。
在创建配置期间,生成器代理通过 A2A 协议调用验证器代理。验证器获取生成的配置和原始用户请求,然后检查配置是否真正解决了提出的任务?是否指定了所有必需参数?是否存在逻辑错误或潜在的性能问题?验证器可以回答「配置正确」或请求修正:「filters 部分缺少必需参数 field_name」或「对于 production 环境,我建议添加 SSL 连接」。
代理以迭代方式交互,直到获得有效配置。这可能需要几个周期:生成器创建第一个版本,验证器发现问题,生成器根据反馈进行修正,验证器再次检查。通常需要一到三次迭代。整个过程完全自动化,只需几秒钟,而不是数小时的手动调试。
在配置通过 AI 检查后,可以使用静态方法进一步验证。Config Validator 检查 YAML 语法是否正确、JSON 架构是否有效,如果配置用于在 Kubernetes 中部署——检查是否符合清单规范。
可以通过正则表达式配置自定义检查:例如,确保主题名称符合企业命名惯例(naming convention)。完成的结果可以通过内置部署机制直接应用到集群,或复制并在现有 CI/CD 管道中使用。
向量数据库:AI 如何理解文档
在转向架构之前,让我们先了解系统的基础——向量数据库和嵌入机制。这是一项关键技术,使语义搜索和上下文生成成为可能。
什么是嵌入
嵌入是一种将文本表示为固定长度数值向量的方法,通常根据模型而定为 384 到 1536 维。
这个向量中的每个数字是多维空间中的一个坐标,其中点的位置反映了文本的语义含义。嵌入的关键特性是,语义上相似的文本具有相近的向量,可以通过计算向量之间的距离或余弦相似度来找到文本。
例如,考虑文档中的三个短语:「Kafka 源」可以表示为向量 [0.82, -0.33, 0.15, 0.67, ...],「Kafka input」可以表示为向量 [0.81, -0.35, 0.14, 0.65, ...],「从消息队列读取」可以表示为 [0.77, -0.33, 0.14, 0.63, ...]。
所有这三个短语都描述了从消息代理获取数据的类似概念,它们的向量表示在多维空间中彼此接近。第一个和第二个向量之间的距离很小,而与完全无关的短语(如「配置网络策略」)之间的距离要大得多。
重要的是要理解,嵌入不是简单地计算公共单词的数量。创建嵌入的模型在大量文本上进行了训练,理解上下文、同义词、概念之间的联系。因此,「Kafka source」和「从主题读取」将具有相近的嵌入,即使它们没有共同的单词。
文档索引
当将文档加载到系统中时,会进行几个重要的处理步骤。
首先,文档被分成语义片段——块。这是一个至关重要的步骤,因为分割质量直接影响搜索质量。过小的块会失去上下文,过大的块会变得不够具体,可能包含多个不相关的主题。
我们根据文档的具体情况调整块大小。对于包含参数简短说明的参考文档,最优大小是 256-512 个令牌。我们使用块之间的重叠(overlap),大小为块大小的 10-20%。这意味着一个块的最后几句话会在下一个块的开头重复。为什么?为了保持边界处的上下文。如果某个概念的描述落在块之间的边界,重叠可以保证在其中一个块中完整地呈现该描述。
我们使用 Sber 的 Embeddings 模型将每个块转换为向量。我们选择它是因为它专门针对俄语进行了训练,并为俄语技术文本创建高质量的语义表示。该模型理解特定的术语、缩写词和技术术语。
向量表示被保存在 Platform V Vector DB 中——一个专门为高性能语义搜索设计的向量数据库。除了向量,我们还存储片段的原始文本和元数据:文档来源、部分、更新日期、标签(例如 kafka、filters、security)。这允许进行精确的过滤搜索——例如,仅搜索 Kafka 相关材料或仅搜索与安全相关的部分。
比如说,一份网络策略配置规则文档可以这样分割:名为"默认禁止所有入站流量"的文本块会获得向量 [0.76, -0.21, 0.94, ...] 和元数据 {source: "network-policy.yaml", section: "ingress-rules", tags: ["security", "network"]},而下一个文本块"仅允许来自 frontend 命名空间的 80 端口"会获得自己的向量 [0.68, -0.19, 0.91, ...] 和相似的元数据。在搜索查询"仅为前端服务配置访问权限"时,系统会将这两个文本块都识别为相关的,其中第二个会获得更高的分数。
RAG: Retrieve-Augment-Generate
让我们来理解为什么仅仅使用 LLM 对我们的任务来说是不够的。现代语言模型,如 GigaChat、GPT 或 Claude,具有令人印象深刻的文本生成和理解上下文的能力。但它们有根本性的限制。
首先,模型可能不了解你的文档特殊性。GigaChat 是在互联网的公共数据上训练的,但我们的内部文档、Platform V Synapse Streaming Event Processing、专有 DSL 和企业标准在训练集中并不存在。
其次,模型的知识受限于训练日期。如果最后一次训练是半年前,而在此期间产品已经发布了三个更新并引入了新参数,那么模型对此一无所知。
第三,模型可能会"产生幻觉":编造不存在的参数,混淆不同版本的语法,生成听起来真实但不正确的配置。
RAG(检索增强生成)是一种架构模式,其中模型不仅仅依靠训练过程中获得的知识,而是首先从外部源——在我们的情况下是包含文档的向量数据库——获取最新的上下文。这从根本上改变了方法:模型不再是知识的来源,而是文档的解释器,能够理解用户的查询并正确地应用从找到的片段中获得的信息。
RAG 的三个阶段
检索(Retrieve)。当用户输入查询时,系统不会立即将其发送到 LLM。首先,查询被向量化——通过用于索引文档的同一个 Embeddings 模型转换为嵌入。得到查询向量。然后系统在向量数据库中搜索具有最相似向量的文本块,通过计算查询向量与数据库中所有文本块向量之间的余弦相似度。
这是语义搜索:我们不是按照确切的词语匹配搜索,而是按照意义搜索。例如,查询"按 timestamp 字段配置大于昨天日期的事件过滤"会找到相关的片段,即使文档中使用了不同的措辞如"时间过滤"、"按时间截断"、"filter by time field"或具有不同字段名称的示例。模型理解所有这些短语在语义上是相近的。
系统返回前 K 个最相关的文本块,通常 K=3-5。数量越多不一定越好:过多的上下文可能会让模型感到困惑,会增加提示中的令牌数(因此增加成本和处理时间),可能包含相关性较低的信息。我们通过实验为我们的系统选择了最优值。
增强(Augment)。找到的文本块不是简单地连接起来,而是被结构化和格式化。形成一个由几个部分组成的提示。System_prompt 定义了代理的角色和行为规则,以下是系统提示的一部分:
你是为 Cloud Event Processing 生成配置文件和 DSL 变换的生成器,严格按照规范和给定的上下文行动。主要要求:仅使用此提示中的信息。仅根据规范或给定的上下文生成语法和语义上有效的配置和 DSL 文件。所有必需字段都必须填充。如果无法正确填充必需字段,则不要生成文件。不要使用规范或给定上下文中未描述的构造、块、参数、函数或语法。任何偏差都是错误。不要在任何文件中添加说明、描述、注释或虚构的元素。如果需要多个文件(例如 config 和 transform),请用单独的块输出每个文件,并指定名称和扩展名。要改进生成质量,请使用在上下文字段中传递的信息。文件名和扩展名是块的第一行。不允许重复的名称。
Context 包括来自文档的相关片段,以特殊方式格式化。每个片段前面都有一个标题,指示来源:「来自'Kafka 源配置'部分」、「文档示例」、「最佳实践」。这帮助模型理解信息来自何处以及应如何解释。如果找到代码示例,它们会完整地包含注释。
User_request 是原始用户查询,可能稍微改述以求清晰。例如,如果用户写了「像上次一样创建一个处理器,但用于不同的主题」,系统可能会要求澄清详细信息。
生成(Generate)。完全形成的提示被发送到 GigaChat。重要的细节:我们使用特定的生成参数。Temperature(温度)设置为相对较低的值,约 0.5,这使生成更具确定性和可预测性,这对于代码和配置生成至关重要。高温度(0.8-1.0)适合创意任务,但在我们的情况下可能导致对语法的"创意解释"。
LLM 生成答案,既基于其对 YAML/JSON 格式和配置一般原则的基本知识,也基于从文档提供的上下文。这保证了配置将符合产品的当前规范,使用正确的参数名称,遵守 API 版本,遵循最佳企业实践。
解决方案的微服务架构
该系统被构建为一组独立的微服务,这提供了灵活性、可扩展性以及能够在不停止整个系统的情况下更新各个组件。
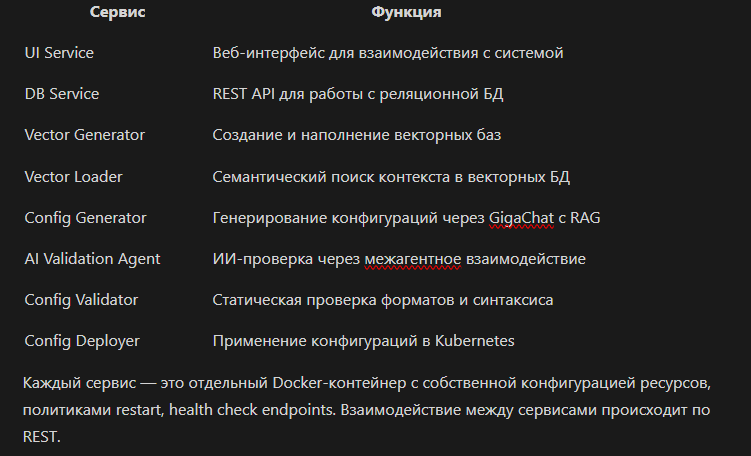
每个服务都是一个单独的 Docker 容器,具有自己的资源配置、重启策略和健康检查端点。服务之间的交互通过 REST 进行。
UI 服务
这是工程师的单一入口点。功能包括管理配置工作的完整周期。这只是一种实现方式,系统的设计使得可以通过 REST API 直接访问其他服务,将其集成到现有的 CI/CD 流程中。
例如,可以配置Jenkins pipeline来调用配置生成器API,根据Git仓库中的参数自动生成配置,通过配置验证器检查结果,并通过配置部署器应用。界面是用于交互工作的表示层,但不是必须的环节。
数据库服务
这是系统元数据的中央存储库和用于处理数据库管理系统的REST API。数据库存储各种类型配置的系统提示。每种配置类型都有自己优化的提示,包括模型说明、期望输出格式的示例、必需参数和可选参数的列表。
验证规则以结构化形式存储:用于检查名称的正则表达式模式、数字参数的范围、枚举字段的允许值列表。部署模板是用于Kubernetes清单的Jinja2模板,带有生成的配置的占位符。
向量数据库元数据包括数据库名称、描述、创建日期、块数、使用的embeddings模型、分块参数(大小、重叠)、状态(活跃/不活跃)、过滤标签。
生成历史被完整记录:请求的时间戳、user_id、请求文本、配置类型、使用的向量数据库、找到的上下文、生成的配置、验证结果、部署状态(如适用)。这些数据对于分析系统工作质量和改进非常宝贵。
向量生成器
这是文档的ETL管道。它负责创建和填充向量知识库,将非结构化文本转换为可搜索的向量表示(searchable embeddings)。
该过程从创建向量数据库开始:在Platform V Vector DB中使用指定参数初始化新数据库(集合)。然后进行文档处理:加载各种格式的文件,自动检测格式并进行解析。
接下来进行分块,每个向量数据库的块大小单独配置——256或512个token。重叠(overlap)也可配置:通常是块大小的10-20%,但对于具有大量交叉参考示例的技术文档,可能增加到30%。之后生成embeddings。
元数据同步是最后阶段,将向量数据库的信息注册到数据库服务以供其他组件使用。向量生成器还能够增量更新现有数据库:添加新文档、更新已更改的文档(通过内容哈希)、删除过时的文档。这使得无需完全重新索引即可保持向量数据库的最新状态。
向量加载器
实现RAG的关键组件,是用户请求和文档之间的桥梁。该服务可以并行处理多个并发请求。
工作从数据库服务请求活跃的向量数据库开始。可以过滤特定配置类型要使用哪些数据库——例如,为了生成Kafka source,只在标记为"kafka"和"sources"的数据库中搜索,忽略不相关的数据库。
上下文构建是指按照与原始请求的相似度系数(similarity score)排名前5的块。
结果是一个有序的块列表,包含元数据,可用于代入提示。
配置生成器
系统的核心,是整个生成过程的协调者。这是一个用于与GigaChat API交互的异步服务。当它收到来自用户的请求(通过界面或直接通过API)时,工作流程启动。首先自动调用向量加载器获取相关上下文——这是同步调用,配置生成器等待结果。然后从数据库服务加载系统提示,该提示特定于所生成配置的类型。
形成完整请求,结合系统提示、上下文和用户请求。这里的顺序很重要:首先系统提示设置角色和规则,然后上下文提供知识,最后用户请求指定具体任务。这帮助模型正确优先处理信息。
请求与生成参数配置一起发送到GigaChat。
获得生成的配置后,配置生成器不会立即返回给用户。相反,自动启动验证。在其中,配置生成器在多智能体系统中充当协调者角色,通过A2A协议维持与AI验证代理的交互以进行协调。这是一个异步过程,带有回调:配置生成器将配置发送进行验证并订阅结果通知。
AI验证代理
这是系统中的第二个AI代理,专门用于验证。重要的是:这是一个独立的服务,有自己的提示和模型,而不是配置生成器的一部分。为什么?因为生成和验证任务需要不同的方法、不同的提示和不同的模型参数。
代理通过A2A协议接收验证请求,其中包含生成的配置、原始用户请求和来自文档的上下文(生成时使用的相同块)。这至关重要:验证器必须看到相同的上下文,以便相对于最新文档而不是对"正确"的抽象理解来评估正确性。
执行几种类型的分析。正确性分析检查配置是否真的解决了提出的任务——如果用户要求"按user_id > 1000过滤",配置中是否有相应的过滤器?参数是否正确指定?完整性分析确保指定了所有必需参数:每种配置类型都有包含必需字段的架构,验证器会与之进行比对。
风格分析检查是否遵循最佳实践和公司标准——例如,是否使用了推荐的默认值,是否根据网络安全要求设置了所有必需的字段,是否启用了日志记录。这是一个简单的检查:配置可能在技术上是正确的,但不符合公司标准。验证器将其标记为警告而不是错误。
安全分析是最重要的之一——它发现了潜在问题:数据传输是否使用TLS,配置中是否没有硬编码的秘密。验证器经过训练可以识别不安全配置的模式。
代理返回结构化响应:总体判定(valid、invalid、warning)、置信度指标(代理对评估的置信程度,范围 0 到 100)、问题列表(每个问题都指定优先级:error、warning、info、在配置中的位置及问题描述)以及改进建议。如果发现错误,Config Generator 可以自动请求重新生成,将发现的问题描述包含在提示词中("上一个版本中有错误 X,请修复它")。
Config Validator
这是防止语法错误和架构违规的防护层,与 AI Validation Agent 并行工作。这是经典的无 AI 验证器,但同样重要。
YAML/JSON 格式检查使用 yamllint 和内置的 Python 解析器,提供详细的错误消息——不只是「invalid YAML」,而是「line 15, column 3: expected indentation of 2 spaces but found 4」。Kubernetes 清单检查验证是否符合 Kubernetes API 规范:apiVersion 是否正确指定、是否存在这样的 kind、所有必需字段(required fields)是否在 metadata/spec 中存在。
针对特定模式的 Regex 检查:可以设置类似「主题名称应符合模式 ^[a-z0-9-]+$」、「端口应在 1024-65535 范围内」、「生产环境中的命名空间不能为 'default'」的规则。Kubernetes 中的 Dry-run——在实际应用前的最终检查:将清单发送到 Kubernetes API,并使用标志 dryRun=true,API 在不实际创建资源的情况下检查正确性。
所有检查的结果都组合在一个统一的报告中,按备注类型分类,并提供修复建议。
Config Deployer
这是链中的最后一个环节,负责在 Kubernetes 中安全部署配置。
系统支持两种工作模式。在直接清单生成模式下,模型立即创建完整的 Kubernetes 清单,包含 Deployment、Service、ConfigMap 的完整规范和所有必要字段。这更快,但灵活性较低。在模板化模式下,使用预先准备的清单模板,采用企业标准:监控用的 labels、service mesh 用的 annotations、imagePullSecrets、resource requests/limits、liveness/readiness probes。LLM 只生成配置的业务逻辑(例如应用设置),然后将其替换到模板中。
第二种方法保证了部署的一致性、对企业政策的遵守以及与现有基础设施的集成。模板创建机制的基础是 Jinja2,配有自定义过滤器和函数来处理特定情况。
完整的系统工作周期
让我们通过一个真实例子来追踪从请求到应用配置的详细路径。
用户——工程师 Alexey——收到任务:需要配置一个处理程序来过滤来自 Kafka 源的事件,只保留来自 user_id 大于 1000 且优先级为 high 的用户的事件,并将结果发送到新主题进行进一步处理。在过去,Alexey 会打开文档、查找 Kafka source 配置示例,然后找到关于过滤器和 destination 的部分,并将所有内容组合在一起。
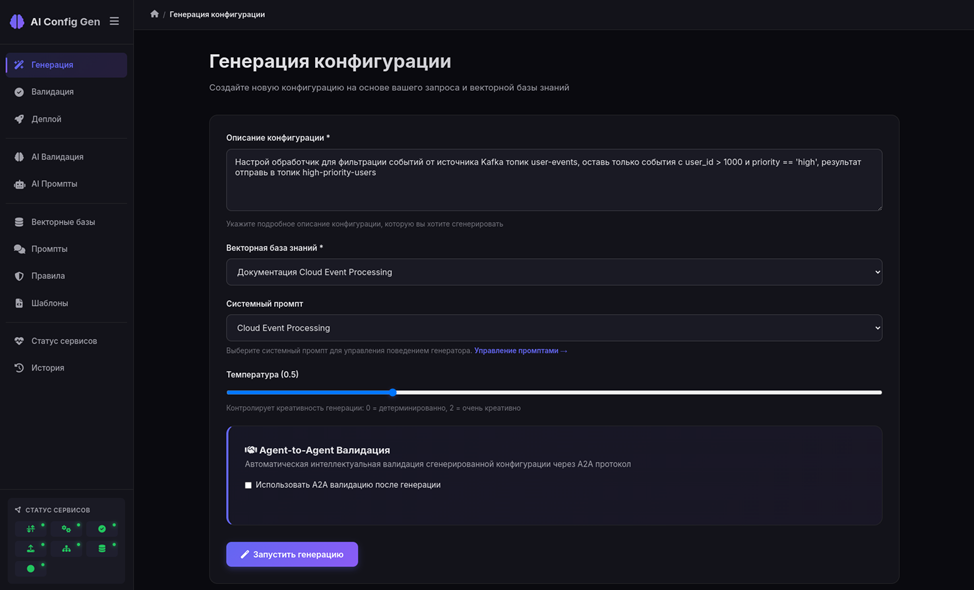
现在 Alexey 只需打开我们系统的界面,选择 Cloud Event Processing 配置类型,在文本字段中输入:"配置一个处理程序来过滤来自 Kafka 主题 user-events 的事件,只保留 user_id > 1000 和 priority == 'high' 的事件,并将结果发送到 high-priority-users 主题"。点击"启动生成"。
Vector Loader 接收请求,通过 Embeddings 将其向量化,在向量数据库中搜索。找到前 5 个块:"Kafka 源配置,包含指定 bootstrap servers 和 topic 的示例"、"数字字段的 filter expression 语法"、"字符串字段和枚举值的 filter expression 语法"、"组合多个过滤器的示例"、"用于写入 Kafka 主题的 destination 配置"。这些块以相似度系数 0.89、0.87、0.85、0.82、0.79 依次返回给 Config Generator。
Config Generator 从 DB Service 获取系统提示词,其中包含指令:"生成 CONF 格式的配置。结构:source、aggregationStep、transformStep、destination。使用示例中的精确语法。不要编造不存在的参数"。它组合提示词、上下文和用户请求,形成完整的提示词。
将其发送到 GigaChat API,同时使用精心选择的生成参数。Temperature=0.5,我们上面讨论了为什么选择这个值。不过,我们还向模型传递了另一个参数——max_tokens,值为 1500,这限制了响应的长度。对于中等复杂度的配置,这就足够了:典型的 Cloud Event Processing 配置占用大约 300 个 token。预留空间用于模型的注释和可能的说明。限制太小(500-800)会在中途截断复杂配置,太大(3000+)会让模型生成过多内容:额外的示例、解释、替代方案,这会增加解析结果的难度。
Config Generator 通过 A2A 协议自动将此配置发送给 AI Validation Agent。验证器在原始请求和找到的文档的背景下分析它。检查:是否有 user_id > 1000 的过滤器?是的。priority == 'high' 的过滤器?是的。Destination 指向正确的主题吗?是的。所有必需字段都存在吗?检查 source(type、config.bootstrap_servers 和 config.topic 存在)、transformStep(结构正确)、destination(type 和 config 存在)——一切就绪。
验证器注意到使用了占位符 ${KAFKA_BOOTSTRAP} 而不是硬编码的地址——这符合公司标准,标记为正面。检查安全性:是否有以明文显示的凭证?没有。是否使用 group_id 来避免处理重复?是的。置信度指标计算为 0.94(非常确信)。
验证器返回判定:{status: "valid", confidence: 0.94, issues: [], recommendations: ["Рассмотрите возможность добавления политики обработки ошибок для сообщений о сбоях"]}。
Config Generator 获得肯定判定,启动 Config Validator 进行静态检查。Validator 按规范对生成的 CONF 文件进行静态验证。
在界面中,Alexey 看到生成的配置,带有绿色勾选"Validated"和以信息提示形式提供的建议。配置看起来是正确的。Alexey 点击"在命名空间中安装配置"。
Config Deployer 接收请求,从 DB Service 加载 Kubernetes 清单模板用于 Cloud Event Processing 组件,将生成的配置代入模板以进行部署。通过 Kubernetes API 执行 dry-run。API 返回 success——清单正确,将被接受。Deployer 应用配置。Kubernetes 创建资源,启动包含 Cloud Event Processing 组件的 Pod。Config Deployer 监控状态:等待 Pod 转换到 Running 状态,检查 readiness probe。15 秒后,Pod 就绪,健康检查为绿色。Deployer 在 DB Service 中保存记录:applied successfully、时间戳、user: Алексей、namespace: dev,以及已生成的清单。
在界面中,Алексей 看到「已成功部署到 dev namespace」、绿色指示器、指向 Kubernetes dashboard 中 Pod 的链接。从请求到集群中工作配置花费了 30 秒。Алексей 面带微笑地看着显示器。
系统如何与专有 DSL 配合工作
让我们回到 tr 文件的工作问题——这是我们在文章开头提到的专有 DSL 用于转换。DSL 示例向量化的技术实现有其自身的特点。
在向量数据库中,我们存储的不仅仅是文档文本,而是特别结构化的示例:完整的可工作 tr 文件,分解为带注释的语义块(比如「时间窗口聚合示例」),带解释性注释说明不明显的构造,以及具有变体的典型使用模式。每个示例都作为一个整体进行向量化,不分割成小块——这对保持代码的语法完整性至关重要。
当用户请求生成转换时,Vector Loader 根据任务的语义相似性找到最相关的几个 tr 文件示例。LLM 在提示中获得完整示例,并将其用作模板,调整语法以满足具体的请求。这是 RAG 上下文中的 few-shot learning 技术:模型在执行时从示例中学习,无需额外训练。
结果是,我们获得了高精度的 tr 文件生成,用于模型训练数据中不存在的专有语言。
安全性与隐私
使用企业文档和 production 配置需要严格的安全要求。所有文档都存储在公司周边内的私有向量数据库中,而不是云中的某个地方。我们不会将机密数据发送到外部 API。AI Validation Agent 也经过训练,可以在配置中找到潜在的机密数据泄露并将其标记为安全问题。
结论
我们创建了一个端到端的解决方案,用于自动生成流数据处理配置,将配置创建时间从数小时缩短到数秒,通过自动检查排除 copy-paste 错误和拼写错误。通过 RAG 自动应用文档中的最佳实践,提供两级验证——静态和智能 AI 验证,支持通过标准 A2A 协议进行代理间交互以实现可扩展性。
RAG 被证明是生成专有 DSL 配置的理想解决方案。它使模型能够使用训练数据中不存在的最新和特定文档,通过依靠文档中的真实示例降低幻觉风险,并且易于更新——只需将新文档版本加载到向量数据库中,无需重新训练模型。它可扩展到任何类型的配置和 DSL,这是一种通用方法。
项目的关键技术:RAG 用于生成的上下文化、Platform V Vector DB 向量数据库用于语义搜索、Embeddings 用于为俄语技术文本创建高质量嵌入、GigaChat 作为生成和验证的主要 LLM、A2A 协议用于代理间交互和可扩展性、微服务架构用于灵活性和可伸缩性。
包含 Claude Code 指南和内容的频道,我们发布新闻(当他们削减限额 10 倍时)以及我们为项目通过 Claude 实现的工具,频道:https://t.me/claudedevolper